JavaScript API
入门
为了提高工作效率,我们强烈建议使用我们的 TypeScript 绑定。这样你就能获得代码补全、类型检查、内联文档、 重构工具等功能。
下面是一段简短的预览视频,展示了编辑器中的使用体验:
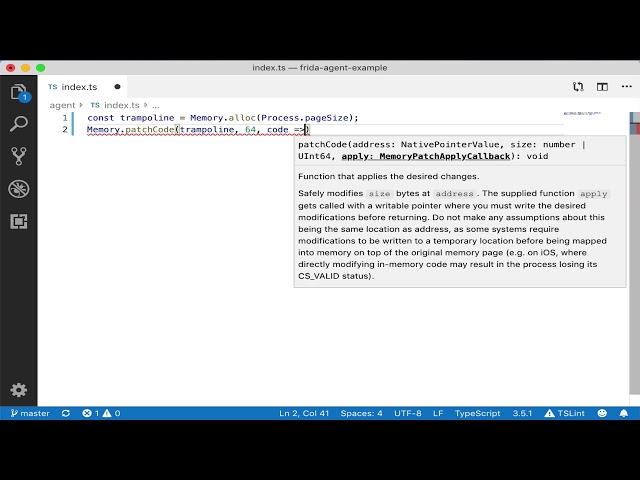
克隆 此仓库 即可开始使用。
目录
- 运行时信息
- Process、Thread、Module 与 Memory
- 数据类型、函数与回调
- 网络
- 文件与流
- 数据库
- 插桩
- CPU 指令
- 其他
运行时信息
Frida
-
Frida.version:包含当前 Frida 版本的字符串属性。 -
Frida.heapSize:动态属性,包含 Frida 当前私有堆的大小;该堆由所有脚本 以及 Frida 自身的运行时共享。通过此属性,可以了解插桩逻辑占用了宿主进程 总内存消耗中的多少内存。
Script
-
Script.runtime:包含当前所用运行时的字符串属性。 其值为QJS或V8。 -
Script.evaluate(name, source):在全局作用域中求值给定的 JavaScript 字符串source,其中name是用于指定脚本名称的字符串,例如/plugins/tty.js。 提供的名称是 UNIX 风格的虚拟文件系统路径,将用于之后的堆栈跟踪。此方法适合希望在自身脚本中支持加载用户所提供脚本的 Agent。与直接使用
eval()相比,它有两个优点:可以指定脚本文件名,并且支持源映射——既支持 内联源映射,也支持通过Script.registerSourceMap()注册的源映射。返回代码求值后的结果值。
-
Script.load(name, source):将给定的 JavaScript 字符串source编译并求值为 ES 模块,其中name是用于指定模块名称的字符串,例如/plugins/screenshot.js。提供的名称是 UNIX 风格的虚拟文件系统路径,将用于 之后的堆栈跟踪;其他模块也能看到该名称,并可通过静态或动态方式导入它。此方法适合希望在自身脚本中支持加载用户所提供脚本的 Agent。除了将用户提供的 代码封装在独立的 ES 模块中之外,此 API 相比
eval()还具有与Script.evaluate()相同的优势。这意味着其中的值可以导出, 随后由其他模块导入。父脚本也可以导出一些值,供加载的子脚本导入。为此, 父脚本必须使用较新版 frida-compile 所采用的新 ES 模块 bundle 格式。返回一个 Promise,它会兑现为该模块的命名空间对象。
-
Script.registerSourceMap(name, json):为指定脚本name注册源映射;该名称 以包含 UNIX 风格虚拟文件系统路径的字符串给出,例如/plugins/screenshot.js。源映射json是包含源映射原始 JSON 表示的字符串。最好在加载给定脚本之前调用此方法,以便加载期间生成的堆栈跟踪能够使用该源映射。
-
Script.nextTick(func[, ...params]):在下一个 tick 运行func,即在当前原生线程 退出 JavaScript 运行时的时候。任何额外的params都会传递给它。 -
Script.pin():暂时阻止当前脚本被卸载。此操作采用引用计数,因此之后必须有一次 对应的 unpin() 调用。通常在 bindWeak() 的回调中使用,以便在需要时将清理工作 调度到另一个线程。 -
Script.unpin():撤销之前的 pin(),使当前脚本可以被卸载。 -
Script.bindWeak(value, fn):监视value;一旦value被垃圾回收,或者脚本即将 卸载,就会调用fn回调。返回一个 ID,你可以将其传给Script.unbindWeak()来显式清理。如果你正在构建语言绑定,需要在不再使用某个 JS 值时释放原生资源,此 API 会很有用。
-
Script.unbindWeak(id):停止监视传给Script.bindWeak(value, fn)的值,并立即 调用fn回调。 -
Script.setGlobalAccessHandler(handler | null):安装或卸载一个处理程序,用于解析 对不存在的全局变量的访问尝试。它适合用于实现 REPL,使未知标识符可以按需从 数据库中延迟获取。handler是一个包含以下两个属性的对象:-
enumerate():查询还存在哪些额外的全局变量。必须返回字符串数组。 -
get(property):获取给定属性的值。
-
Process、Thread、Module 与 Memory
Process
-
Process.id:包含 PID 的数值属性 -
Process.arch:包含字符串ia32、x64、arm或arm64的属性 -
Process.platform:包含字符串windows、darwin、linux、freebsd、qnx或barebone的属性 -
Process.pageSize:以数值形式包含虚拟内存页大小(字节)的属性。 此属性用于提高脚本的可移植性。 -
Process.pointerSize:以数值形式包含指针大小(字节)的属性。 此属性用于提高脚本的可移植性。 -
Process.codeSigningPolicy:包含字符串optional或required的属性;后者表示 Frida 将避免修改内存中现有的代码,也不会尝试运行未签名代码。目前,除非你使用 Gadget 并将其配置为假定必须进行代码签名,否则此属性始终为optional。通过此属性,可以判断 Interceptor API 是否不可用, 以及修改代码或运行未签名代码是否安全。 -
Process.mainModule:包含一个代表进程主可执行文件的Module的属性 -
Process.getCurrentDir():返回一个字符串,指定当前工作目录的文件系统路径 -
Process.getHomeDir():返回一个字符串,指定当前用户主目录的文件系统路径 -
Process.getTmpDir():返回一个字符串,指定用于存放临时文件的目录路径 -
Process.isDebuggerAttached():返回布尔值,表示当前是否附加了调试器 -
Process.getCurrentThreadId():以数值形式获取当前线程在操作系统中的 ID -
Process.findThreadById(id)、Process.getThreadById(id):返回一个 id 与指定值 匹配的 Thread。如果找不到这样的线程,findThreadById() 返回 null,而 getThreadById() 抛出异常。与enumerateThreads()不同,被隐藏的线程不会在这里被 隐去,因为使用 ID 显式查找时,只要线程存在就始终会将其返回。 -
Process.enumerateThreads():枚举正在运行的线程,返回 Thread 对象数组。 -
Process.attachThreadObserver(callbacks):开始观察线程,并在线程被添加、移除或 重命名时调用所提供的callbacks。callbacks参数是一个包含以下一个或多个属性的对象:-
onAdded(thread):回调函数,参数为刚添加的Thread。该回调会立即 接收所有现有线程,因此无需担心竞态条件,就能轻松处理初始状态与后续更新。 如果参数是刚创建的新线程,此调用会从该新线程同步发生。 -
onRemoved(thread):回调函数,参数为刚移除(即将终止)的Thread。此调用会从即将终止的线程同步发生。 -
onRenamed(thread, previousName):回调函数,第一个参数为刚重命名的Thread,其name属性已是新名称;第二个参数previousName指定其旧名称。旧名称可能是字符串;如果线程此前没有名称,则为null。
请注意,
Thread对象不包含state和context属性,因为它们高度 易变,而且系统不会观察其变化。你可以将此 API 与Stalker结合使用, 以跟踪各个线程的执行。返回一个观察器对象,你可以对其调用
detach()。 -
-
Process.runOnThread(id, callback):在id指定的线程上运行不带任何参数的 JavaScript 函数callback。返回一个 Promise,它会接收到回调的返回值。使用此方法时必须格外谨慎,因为线程可能会在不可重入代码中被中断。例如,线程可能 正在执行某段敏感代码并持有某个特定的非递归锁,而你调用某个函数时又试图隐式获取 同一把锁。
-
Process.findModuleByAddress(address)、Process.getModuleByAddress(address)、Process.findModuleByName(name)、Process.getModuleByName(name): 返回一个 address 或 name 与指定值匹配的 Module。如果找不到 这样的模块,以 find 开头的函数返回 null,以 get 开头的函数则抛出异常。 -
Process.enumerateModules():枚举当前已加载的模块,返回 Module 对象数组。 -
Process.attachModuleObserver(callbacks):开始观察模块,并在模块添加或移除时 调用所提供的callbacks。callbacks参数是一个包含以下一个或多个属性的对象:-
onAdded(module):回调函数,参数为刚添加的Module。该回调会立即 接收所有现有模块,因此无需担心竞态条件,就能轻松处理初始状态与后续更新。 如果参数是新模块,此调用会在模块加载完成后、应用有机会使用它之前同步发生。 因此,这是使用Interceptor等工具应用插桩逻辑的好时机。 -
onRemoved(module):回调函数,参数为刚移除(即已卸载)的Module。
返回一个观察器对象,你可以对其调用
detach()。 -
-
Process.findRangeByAddress(address)、getRangeByAddress(address): 返回一个对象,其中包含内含 address 的内存范围的详细信息。如果找不到这样的范围, findRangeByAddress() 返回 null,而 getRangeByAddress() 抛出异常。所含字段的 详情请参阅Process.enumerateRanges()。 -
Process.findFunctionRange(address)、getFunctionRange(address):返回一个带有base和size属性的对象,用于描述 address 所属函数的代码范围;该范围从平台的 栈展开表中推导得出。如果函数体分布在多个范围内(例如包含冷代码片段),则每个片段 由一个范围表示,并返回覆盖 address 的那个范围。如果没有可用的栈展开信息,例如 叶函数或完全没有栈展开表的二进制文件,则尽力以所属符号的边界作为后备。如果两种方式 都无法得到范围,findFunctionRange() 返回 null,而 getFunctionRange() 抛出异常。 -
Process.enumerateRanges(protection|specifier):枚举满足protection条件的内存 范围;该参数是形如rwx的字符串,其中rw-表示“至少必须可读、可写”。 也可以提供一个specifier对象,其protection键的值采用上述格式;如果希望合并 具有相同保护属性的相邻范围,还可以将coalesce键设为true(默认为false, 即各范围保持独立)。返回一个对象数组,其中的对象包含以下属性:-
base:以NativePointer表示的基址 -
size:以字节为单位的大小 -
protection:保护属性字符串(见上文) -
file:(可用时)一个包含文件映射详情的对象, 其中包含:-
path:完整文件系统路径,以字符串表示 -
offset:映射文件在磁盘上的偏移量,以字节为单位 -
size:映射文件在磁盘上的大小,以字节为单位
-
-
-
Process.enumerateMallocRanges():与enumerateRanges()类似,但枚举的是系统堆已知的各个 内存分配。 -
Process.setExceptionHandler(callback):安装进程级异常处理回调,使其有机会在 宿主进程自身处理原生异常之前进行处理。调用时只传入一个参数details,它是包含 以下内容的对象:-
type:指定以下值之一的字符串:- abort
- access-violation
- guard-page
- illegal-instruction
- stack-overflow
- arithmetic
- breakpoint
- single-step
- system
-
address:发生异常的地址,以 NativePointer 表示 -
memory:如果存在,则为一个包含以下内容的对象:-
operation:触发异常的操作类型,以字符串表示,值为read、write或execute -
address:异常发生时所访问的地址,以 NativePointer 表示
-
-
context:包含pc和sp键的对象,这两个键的值是 NativePointer 对象,分别表示 ia32/x64/arm 上的 EIP/RIP/PC 和 ESP/RSP/SP。还提供其他处理器专用的键,例如eax、rax、r0、x0等。也可以通过为这些键赋值来更新寄存器值。 -
nativeContext:操作系统和架构专用 CPU 上下文结构的地址,以 NativePointer 表示。它只作为最后手段开放,用于context无法提供足够细节的边缘情况。不过,我们不建议使用它;更好的做法是提交拉取请求, 补充你的使用场景所需但目前缺失的内容。
由你的回调决定如何处理异常。它可以记录问题,通过 send() 通知你的应用,再阻塞调用 recv(),等待确认已收到发送的数据;也可以修改寄存器和内存, 从异常中恢复。如果你已处理异常,应返回
true,此时 Frida 会立即恢复该线程。如果没有 返回true,Frida 会将异常转发给宿主进程的异常处理程序(如果存在),否则让操作系统 终止该进程。请注意,如果打算使用此处理程序捕获所调用的 NativeFunctions 抛出的异常,必须将这些函数的异常行为设为
propagate。 -
Thread
例如,Process.enumerateThreads() 返回的对象。
-
id:操作系统专用的 ID,以数字表示 -
name:线程名称,以字符串表示(如果可用) -
state:线程状态的快照,以字符串表示,值为running、stopped、waiting、uninterruptible或halted -
context:CPU 寄存器的快照,以包含pc和sp键的对象表示;对于 ia32/x64/arm,这两个键的值是 NativePointer 对象, 分别表示 EIP/RIP/PC 和 ESP/RSP/SP。还提供其他处理器专用的键,例如eax、rax、r0、x0等。xmm0和q0等向量寄存器以 ArrayBuffer 对象形式公开,d0和s0等浮点寄存器 以数字表示,cpsr(32 位 ARM)和nzcv(AArch64)等状态寄存器也以 数字表示。 -
entrypoint:线程开始执行的位置(如果适用且可用)。存在时,它是一个 包含以下属性的对象:-
routine:线程的启动例程,以NativePointer表示 -
parameter:传递给routine的参数(如果可用),以NativePointer表示
-
-
setHardwareBreakpoint(id, address):设置硬件断点,其中id是指定断点 ID 的数字,address是指定断点地址的NativePointer。 通常与Process.setExceptionHandler()配合使用,以处理触发的异常。 -
unsetHardwareBreakpoint(id):取消硬件断点,其中id是一个数字,指定先前 通过调用setHardwareBreakpoint()设置的断点 ID。 -
setHardwareWatchpoint(id, address, size, conditions):设置硬件观察点,其中id是指定观察点 ID 的数字,address是指定待监视区域地址的NativePointer,size是指定该区域大小的数字,conditions是值为r、w或rw的字符串。这里,r表示监视读取,w表示监视写入,rw表示同时监视读取和写入。通常与Process.setExceptionHandler()配合使用, 以处理触发的异常。 -
unsetHardwareWatchpoint(id):取消硬件观察点,其中id是一个数字,指定先前 通过调用setHardwareWatchpoint()设置的观察点 ID。 -
Thread.backtrace([context, backtracer]):为当前线程生成回溯,并以NativePointer对象数组的形式返回。如果从 Interceptor 的
onEnter或onLeave回调中调用此方法,应将this.context作为可选的context参数传入,这样可以获得更准确的回溯。省略context意味着从 当前栈位置生成回溯;由于 JavaScript VM 的栈帧,这样得到的回溯可能不太理想。 可选的backtracer参数指定要使用的回溯器类型,必须是Backtracer.FUZZY或Backtracer.ACCURATE;未指定时默认为后者。精确回溯器依赖便于调试的二进制 文件或调试信息,才能取得良好效果;模糊回溯器则对栈进行取证分析来猜测返回地址, 因而会产生误报,但适用于任何二进制文件。生成的回溯目前最多包含 16 个栈帧, 除非重新编译 Frida,否则无法调整这一限制。
const commonCrypto = Process.getModuleByName('libcommonCrypto.dylib');
const f = commonCrypto.getExportByName('CCCryptorCreate');
Interceptor.attach(f, {
  onEnter(args) {
    console.log('CCCryptorCreate called from:\n' +
        Thread.backtrace(this.context, Backtracer.ACCURATE)
        .map(DebugSymbol.fromAddress).join('\n') + '\n');
  }
});-
Thread.sleep(delay):将当前线程暂停执行delay秒,该参数以数字指定。 例如,传入 0.05 可休眠 50 毫秒。
Module
例如,Module.load() 和
Process.enumerateModules() 返回的对象。
-
name:规范的模块名称,以字符串表示 -
version:模块版本,以字符串表示;如果不可用则为null -
base:基址,以NativePointer表示 -
size:大小,以字节为单位 -
path:完整的文件系统路径,以字符串表示 -
ensureInitialized():确保模块初始化器已经运行。这对于早期插桩(即在进程 生命周期早期运行)很重要,以便安全地与 API 交互。其中一种使用场景是与给定 模块提供的 ObjC 类交互。 -
enumerateImports():枚举模块的导入项,返回一个对象数组,其中每个对象包含 以下属性:-
type:字符串,值为function或variable -
name:导入项名称,以字符串表示 -
module:模块名称,以字符串表示 -
address:绝对地址,以NativePointer表示 -
slot:存储导入项的内存位置,以NativePointer表示
对于所有导入项,只有
name字段保证存在。平台专用后端会尽力解析其他字段, 甚至尝试解析原生元数据未提供的信息,但不保证一定成功。 -
-
enumerateExports():枚举模块的导出项,返回一个对象数组,其中每个对象包含 以下属性:-
type:字符串,值为function或variable -
name:导出项名称,以字符串表示 -
address:绝对地址,以NativePointer表示
-
-
enumerateSymbols():枚举模块的符号,返回一个对象数组,其中每个对象包含 以下属性:-
isGlobal:布尔值,指定符号是否全局可见 -
type:字符串,值为以下之一:- unknown(未知)
- section(节)
- undefined(未定义,Mach-O)
- absolute(绝对,Mach-O)
- prebound-undefined(预绑定未定义,Mach-O)
- indirect(间接,Mach-O)
- object(对象,ELF)
- function(函数,ELF)
- file(文件,ELF)
- common(公共,ELF)
- tls(线程局部存储,ELF)
-
section:如果存在,则为包含以下属性的对象:-
id:包含节索引、段名称(如果适用)和节名称的字符串,其格式与 r2 的节 ID 相同 -
protection:保护属性,格式与Process.enumerateRanges()中的相同
-
-
name:符号名称,以字符串表示 -
address:绝对地址,以NativePointer表示 -
size:如果存在,则为指定符号大小的数字,以字节为单位
-
enumerateSymbols() 仅适用于 i/macOS 和基于 Linux 的操作系统
我们也很希望在其他平台上支持此功能。如果你觉得它有用并愿意提供帮助,请与 我们联系。根据你的使用场景,DebugSymbol API 也可能已经足够。
-
enumerateRanges(protection):与Process.enumerateRanges类似,但作用域限定为该模块。 -
enumerateSections():枚举模块的节,返回一个对象数组,其中每个对象包含 以下属性:-
id:包含节索引、段名称(如果适用)和节名称的字符串,其格式与 r2 的节 ID 相同 -
name:节名称,以字符串表示 -
address:绝对地址,以NativePointer表示 -
size:大小,以字节为单位
-
-
enumerateDependencies():枚举模块的依赖项,返回一个对象数组,其中每个对象 包含以下属性:-
name:模块名称,以字符串表示 -
type:字符串,值为以下之一:- regular(常规)
- weak(弱依赖)
- reexport(重新导出)
- upward(向上依赖)
-
-
findExportByName(name),getExportByName(name):返回名为name的导出项的绝对地址。如果找不到该 导出项,以 find 开头的函数返回 null,以 get 开头的函数则抛出异常。 -
findSymbolByName(name),getSymbolByName(name):返回名为name的符号的绝对地址。如果找不到该符号, 以 find 开头的函数返回 null,以 get 开头的函数则抛出异常。 -
Module.load(path):从文件系统路径加载指定模块,并返回一个Module对象。如果无法加载指定模块,则抛出异常。 -
Module.findGlobalExportByName(name),Module.getGlobalExportByName(name):返回名为name的全局导出项的绝对地址。 此搜索的开销可能很高,应尽量避免。如果找不到该导出项,以 find 开头的函数 返回 null,以 get 开头的函数则抛出异常。
ModuleMap
-
new ModuleMap([filter]):创建一个新的模块映射,针对判断给定内存地址属于哪个 模块(如果有)进行了优化。创建时会为当前已加载的模块生成快照,可通过调用update()刷新。filter参数是可选的,允许传入一个用于 过滤模块列表的函数。例如,当你只关心应用自身拥有的模块时,这很有用,并可让你 快速检查某个地址是否属于其中一个模块。filter函数会接收一个 Module 对象,并且必须对每个应保留在映射中的模块返回true。 每次更新映射时,都会对每个已加载模块调用该函数。 -
has(address):检查address是否属于其中任一模块,并以布尔值返回结果 -
find(address),get(address):返回一个 Module,其中包含address所属模块的详细信息。如果找不到这样的模块,find()返回null,get()则抛出异常。 -
findName(address),getName(address),findPath(address),getPath(address): 与find()和get()类似,但只返回name或path字段,因此在不需要其他详细信息时开销更低。 -
update():更新映射。模块加载或卸载后应调用此方法,以免基于过期数据进行操作。 -
values():返回一个数组,其中包含映射中当前的 Module 对象。 返回的数组是深拷贝,调用update()后不会发生变化。
Memory
-
Memory.scan(address, size, pattern, callbacks):扫描pattern在由address和size给定的内存范围中出现的位置。-
pattern必须采用 “13 37 ?? ff” 的形式,以匹配依次出现的 0x13、0x37、 任意字节和 0xff。若要进行更高级的匹配,也可以指定 r2 风格的掩码。 掩码会分别与待查模式和被查数据进行按位与运算。要指定掩码,请在待查模式后 追加一个:字符,再以相同语法写出掩码。例如: “13 37 13 37 : 1f ff ff f1”。为方便起见,还可以指定半字节级通配符, 如 “?3 37 13 ?7”,它会在内部转换为掩码。或者,pattern也可以是由 斜杠包围的正则表达式,例如 “/Some\s*Pattern/”。还可以传入MatchPattern,而非字符串。 -
callbacks是一个包含以下内容的对象:-
onMatch(address, size):匹配时调用,其中address包含匹配项地址, 以NativePointer表示;size以数字指定其大小。此函数可以返回字符串
stop,以提前取消内存扫描。 -
onError(reason):扫描期间发生内存访问错误时调用,并传入reason -
onComplete():完整扫描内存范围后调用
-
-
-
Memory.scanSync(address, size, pattern):scan()的同步版本, 返回一个对象数组,其中每个对象包含以下属性:-
address:绝对地址,以NativePointer表示。 -
size:大小,以字节为单位
如果扫描期间发生内存访问错误,则抛出 JavaScript 异常。
例如:
-
// Find the module for the program itself, always at index 0:
const m = Process.enumerateModules()[0];

// Or load a module by name:
//const m = Module.load('win32u.dll');

// Print its properties:
console.log(JSON.stringify(m));

// Dump it from its base address:
console.log(hexdump(m.base));

// The pattern that you are interested in:
const pattern = '00 00 00 00 ?? 13 37 ?? 42';

Memory.scan(m.base, m.size, pattern, {
  onMatch(address, size) {
    console.log('Memory.scan() found match at', address,
        'with size', size);

    // Optionally stop scanning early:
    return 'stop';
  },
  onComplete() {
    console.log('Memory.scan() complete');
  }
});

const results = Memory.scanSync(m.base, m.size, pattern);
console.log('Memory.scanSync() result:\n' +
JSON.stringify(results));-
new MatchPattern(pattern):将pattern(格式与Memory.scan()接受的字符串相同)编译为匹配模式,可传递给Memory.scan()、Memory.scanSync()、Kernel.scan()和Kernel.scanSync()。 扫描多个范围时,这可避免反复解析同一模式。如果模式无效,则抛出异常。 -
Memory.findPointers(ranges, values[, options]):扫描一个或多个内存范围, 查找与给定值数组中任一值匹配且按指针对齐的字;values是一个NativePointer值数组。对于查找指针这一常见任务(例如查找 对给定地址的引用),这是Memory.scan()的专用 SIMD 加速替代方案。ranges可以是单个范围对象,也可以是此类对象的数组;每个对象都包含base和size属性,与Process.enumerateRanges()返回的 对象类似。可选的options对象可以包含:-
mask:NativePointer位掩码,在比较前应用于每个被扫描的 字和每个值。默认进行精确匹配。例如,传入ptr('0x00007ffffffffff8')可去除 arm64e PAC 和 non-pointer-isa 位。
返回按地址排序的匹配项数组,每个匹配项都是包含以下内容的对象:
-
address:找到匹配字的地址,以NativePointer表示 -
value:匹配的字,即address中存储的值(应用掩码之前)
例如:
-
const target = Memory.allocUtf8String('Hello');
const ranges = Process.enumerateRanges('rw-');
for (const { address } of Memory.findPointers(ranges, [target])) {
  console.log('Found reference at', address);
}-
Memory.alloc(size[, options]):在堆上分配size字节的内存;如果size是Process.pageSize的倍数,则分配一个或多个由操作系统 管理的原始内存页。使用页粒度时,如果需要在给定地址附近分配内存,还可以传入options对象,并指定{ near: address, maxDistance: distanceInBytes }。 返回值是NativePointer;当所有引用它的 JavaScript 句柄都消失时, 底层内存会被释放。这意味着,只要 JavaScript 运行时之外的代码仍在使用该指针, 就需要保留对它的引用。 -
Memory.copy(dst, src, n):与 memcpy() 类似。无返回值。- dst:指定目标基址的
NativePointer。 - src:指定源基址的
NativePointer。 - n:要复制的大小,以字节为单位。
- dst:指定目标基址的
-
Memory.dup(address, size):依次调用Memory.alloc()和Memory.copy()的简写形式。返回一个NativePointer, 其中包含新分配内存的基址。有关内存分配生命周期的详细信息,请参阅Memory.copy()。 -
Memory.protect(address, size, protection):更新一段内存区域的保护属性,其中protection是与Process.enumerateRanges()中格式 相同的字符串。返回一个布尔值,指示操作是否成功完成。
例如:
Memory.protect(ptr('0x1234'), 4096, 'rw-');-
Memory.queryProtection(address):确定address处内存当前的保护属性; 该地址以 NativePointer 指定。返回一个页保护属性字符串, 其格式与Process.enumerateRanges()中的相同。 -
Memory.patchCode(address, size, apply):安全地修改size个字节,修改位置由address指定,该参数以 NativePointer 表示。提供的 JavaScript 函数apply会接收到一个可写指针;你必须先通过该指针写入所需修改, 然后再返回。不要假定该指针与address指向同一位置,因为某些系统要求先将修改 写入临时位置,再映射到原始内存页之上(例如在 iOS 上,直接修改内存中的代码可能 导致进程失去 CS_VALID 状态)。例如:
const gameEngine = Process.getModuleByName('game-engine.so');
const getLivesLeft = gameEngine.getExportByName('get_lives_left');
const maxPatchSize = 64; // Do not write out of bounds, may be a temporary buffer!
Memory.patchCode(getLivesLeft, maxPatchSize, code => {
  const cw = new X86Writer(code, { pc: getLivesLeft });
  cw.putMovRegU32('eax', 9000);
  cw.putRet();
  cw.flush();
});-
Memory.allocUtf8String(str),Memory.allocUtf16String(str),Memory.allocAnsiString(str): 在堆上分配内存,将str编码并写入为 UTF-8/UTF-16/ANSI 字符串。返回的对象 是NativePointer。有关其生命周期的详细信息,请参阅Memory.alloc()。
MemoryAccessMonitor
-
MemoryAccessMonitor.enable(ranges, callbacks):监视对一个或多个内存范围的 访问,并在每个所含内存页第一次被访问时发出通知。ranges可以是单个范围对象, 也可以是此类对象的数组;每个对象都包含:-
base:基址,以NativePointer表示 -
size:大小,以字节为单位
callbacks是一个指定以下内容的对象:-
onAccess(details):同步调用,传入的details对象包含:-
threadId:执行访问的线程 ID,以数字表示。 -
operation:触发访问的操作类型,以字符串表示,值为read、write或execute -
from:执行此次访问的指令地址,以NativePointer表示 -
address:被访问的地址,以NativePointer表示 -
rangeIndex:被访问范围在传递给MemoryAccessMonitor.enable()的范围 列表中的索引 -
pageIndex:被访问内存页在指定范围内的索引 -
pagesCompleted:截至目前已被访问(因而不再受监视)的页总数 -
pagesTotal:最初受监视的页总数 -
context:CPU 寄存器,与Thread#context相同。 也可以通过为这些键赋值来更新寄存器值。
-
-
-
MemoryAccessMonitor.disable():停止监视传递给MemoryAccessMonitor.enable()的其余内存范围。
CModule
-
new CModule(code[, symbols, options]):根据提供的code创建新的 C 模块。code可以是包含待编译 C 源代码的字符串,也可以是包含预编译共享库的 ArrayBuffer。C 模块会被映射到内存中,并可从 JavaScript 完整访问。它适合实现高频回调,例如用于 Interceptor 和 Stalker;也适用于需要启动新线程并在紧密循环中调用函数的场景, 例如模糊测试。
全局函数会自动导出为 NativePointer 属性,属性名与 C 源代码中的名称完全相同。这意味着你可以将它们传给 Interceptor 和 Stalker,或通过 NativePointer 调用它们。
除了可以访问经过筛选的一部分 Gum、GLib 和标准 C API,映射进来的代码还可以 通过向其公开的
symbols与 JavaScript 通信。这是可选的第二个参数,它是一个 对象,用于指定额外的符号名称及其 NativePointer 值; 每个符号都会在创建模块时接入。例如,它可以包含一个或多个通过 Memory.alloc() 分配的内存块,和/或用于接收 C 模块回调的 NativeCallback 值。如需执行初始化和清理,可以定义具有以下名称和签名的函数:
void init (void)void finalize (void)
请注意,所有数据都是只读的,因此可写全局变量应声明为 extern,使用 Memory.alloc() 等方式分配,并通过构造函数的第二个参数 作为符号传入。
可选的第三个参数
options是一个对象,可用来指定使用哪种工具链,例如:{ toolchain: 'external' }。支持以下值:-
internal:使用静态链接到运行时中的 TinyCC。它从不访问文件系统, 即使在沙箱进程中也能工作。不过,生成的代码不会进行优化,因为 TinyCC 优先考虑较小的编译器体积和较短的编译时间。 -
external:使用目标系统提供的工具链,前提是当前执行所在的进程能够访问它。 -
any:如果Process.arch受 TinyCC 支持,则等同于internal;否则使用external。未指定时默认采用此行为。
-
dispose():立即从内存中取消映射该模块。适用于生命周期较短、且不希望等待 后续垃圾回收的模块。 -
builtins:一个对象,用于说明从 C 源代码构造 CModule 时可用的内建内容。 脚手架工具(如frida-create)通常用它来搭建与 CModule 所用环境相匹配的 构建环境。具体内容取决于Process.arch和 Frida 版本, 可能类似下面这样:{ defines: { 'GLIB_SIZEOF_VOID_P': '8', 'G_GINT16_MODIFIER': '"h"', 'G_GINT32_MODIFIER': '""', 'G_GINT64_MODIFIER': '"ll"', 'G_GSIZE_MODIFIER': '"l"', 'G_GSSIZE_MODIFIER': '"l"', 'HAVE_I386': true }, headers: { 'gum/arch-x86/gumx86writer.h': '…', 'gum/gumdefs.h': '…', 'gum/guminterceptor.h': '…', 'gum/gummemory.h': '…', 'gum/gummetalarray.h': '…', 'gum/gummetalhash.h': '…', 'gum/gummodulemap.h': '…', 'gum/gumprocess.h': '…', 'gum/gumspinlock.h': '…', 'gum/gumstalker.h': '…', 'glib.h': '…', 'json-glib/json-glib.h': '…', 'capstone.h': '…' } }
示例
const cm = new CModule(`
#include <stdio.h>

void hello(void) {
  printf("Hello World from CModule\\n");
}
`);

console.log(JSON.stringify(cm));

const hello = new NativeFunction(cm.hello, 'void', []);
hello();
可以使用 Frida 的 REPL 加载它:
$ frida -p 0 -l example.js(REPL 会监视磁盘上的文件,并在文件发生变化时重新加载脚本。)
随后可以在 REPL 中输入 hello() 来调用该 C 函数。
进行原型开发时,我们建议使用 Frida REPL 内置的 CModule 支持:
$ frida -p 0 -C example.c你还可以添加 -l example.js,在旁边加载一些 JavaScript。JavaScript 代码可以通过
名为 cm 的全局变量访问 CModule 对象,但只能在
rpc.exports.init() 被调用后访问,因此所有依赖 CModule 的初始化
都应在该函数中完成。你也可以通过给名为 cs 的全局对象赋值来注入符号,但必须在
rpc.exports.init() 被调用之前完成。
示例如下:

有关 CModule 的更多详情,请参阅 Frida 12.7 发布说明。
RustModule
将 Rust 源代码直接编译为内存中的机器码。
-
new RustModule(code[, symbols, options]):根据提供的code创建新的 Rust 模块;code是包含待编译 Rust 源代码的字符串。Rust 模块会被映射到内存中, 并可从 JavaScript 完整访问。它适合实现高频回调,例如用于 Interceptor 和 Stalker;也适用于需要启动新线程并在紧密循环中调用函数的场景, 例如模糊测试。
公有函数会自动导出为
NativePointer属性。这意味着你可以 将它们传给 Interceptor 和 Stalker,或通过NativeFunction调用。此时通常应确保这些函数标记为#[no_mangle]和extern "C"。除 Rust 库之外,映射进来的代码还可以通过向其公开的
symbols与 JavaScript 通信。该对象将符号名称映射到NativePointer值。 在 Rust 源代码中应将它们声明为extern "C"。例如,它可以包含一个或多个通过Memory.alloc()分配的内存块,和/或用于接收 Rust 模块回调的NativeCallback值。可选的第三个参数
options是一个对象,可用于指定要使用的 Cargo 依赖项,例如:{ dependencies: ['base64 = "0.22.1"', 'anyhow = "1.0.97"'] }。 -
dispose():立即从内存中取消映射该模块。适用于生命周期较短、且不希望等待 后续垃圾回收的模块。
ApiResolver
-
new ApiResolver(type):创建一个给定type的新解析器,可通过名称快速查找 API,并允许使用 glob。具体有哪些解析器可用,取决于当前平台以及当前进程中已 加载的运行时。在撰写本文时,可用的解析器如下:-
module:解析模块的导出、导入和节。始终可用。 -
swift:解析 Swift 函数。在已加载 Swift 运行时的进程中可用。可以使用Swift.available在运行时检查,或用 try-catch 包裹new ApiResolver('swift')调用。 -
objc:解析 Objective-C 方法。在 macOS 和 iOS 上已加载 Objective-C 运行时的进程中可用。可以使用ObjC.available在运行时 检查,或用 try-catch 包裹new ApiResolver('objc')调用。
解析器在创建时只加载所需的最少数据,并根据收到的查询延迟加载其余数据。因此, 建议对一批查询复用同一个实例,但在处理后续批次时重新创建实例,以免看到过时数据。
-
-
enumerateMatches(query):执行解析器特定的query字符串。可以在字符串末尾 添加/i以执行不区分大小写的匹配。返回一个对象数组,其中每个对象包含以下属性:-
name:找到的 API 名称 -
address:地址,以NativePointer表示 -
size:如果存在,则为指定字节大小的数字
-
const resolver = new ApiResolver('module');
const matches = resolver.enumerateMatches('exports:*!open*');
const first = matches[0];
/*
 * Where `first` is an object similar to:
 *
 * {
 *   name: '/usr/lib/libSystem.B.dylib!opendir$INODE64',
 *   address: ptr('0x7fff870135c9')
 * }
 */
const resolver = new ApiResolver('module');
const matches = resolver.enumerateMatches('sections:*!*text*');
const first = matches[0];
/*
* Where `first` is an object similar to:
*
* {
* name: '/usr/lib/libSystem.B.dylib!0.__TEXT.__text',
* address: ptr('0x191c1e504'),
* size: 1528
* }
*/const resolver = new ApiResolver('swift');
const matches = resolver.enumerateMatches('functions:*CoreDevice!*RemoteDevice*');
const first = matches[0];
/*
* Where `first` is an object similar to:
*
* {
* name: '/Library/Developer/PrivateFrameworks/CoreDevice.framework/Versions/A/CoreDevice!dispatch thunk of CoreDevice.RemoteDevice.addDeviceInfoChanged(on: __C.OS_dispatch_queue?, handler: (Foundation.UUID, CoreDeviceProtocols.DeviceInfo) -> ()) -> CoreDevice.Invalidatable',
* address: ptr('0x1078c3570')
* }
*/const resolver = new ApiResolver('objc');
const matches = resolver.enumerateMatches('-[NSURL* *HTTP*]');
const first = matches[0];
/*
* Where `first` is an object similar to:
*
* {
* name: '-[NSURLRequest valueForHTTPHeaderField:]',
* address: ptr('0x7fff94183e22')
* }
*/DebugSymbol
-
DebugSymbol.fromAddress(address)、DebugSymbol.fromName(name):查找address/name的调试信息,并以包含以下属性的对象形式返回:-
address:该符号对应的地址,以NativePointer表示。 -
name:符号名称,以字符串表示;未知时为 null。 -
moduleName:拥有该符号的模块名称,以字符串表示;未知时为 null。 -
fileName:拥有该符号的文件名称,以字符串表示;未知时为 null。 -
lineNumber:fileName中的行号,以数字表示;未知时为 null。
也可以对其调用
toString();与Thread.backtrace()结合使用时非常实用: -
const commonCrypto = Process.getModuleByName('libcommonCrypto.dylib');
const f = commonCrypto.getExportByName('CCCryptorCreate');
Interceptor.attach(f, {
  onEnter(args) {
    console.log('CCCryptorCreate called from:\n' +
        Thread.backtrace(this.context, Backtracer.ACCURATE)
        .map(DebugSymbol.fromAddress).join('\n') + '\n');
  }
});-
DebugSymbol.getFunctionByName(name):解析函数名称,并以NativePointer返回其地址。如果找到多个函数,则返回第一个; 如果无法解析该名称,则抛出异常。 -
DebugSymbol.findFunctionsNamed(name):解析函数名称,并以NativePointer对象数组的形式返回其地址。 -
DebugSymbol.findFunctionsMatching(glob):解析与glob匹配的函数名称,并以NativePointer对象数组的形式返回其地址。 -
DebugSymbol.load(path):加载指定模块的调试符号。
Kernel
-
Kernel.available:一个布尔值,说明 Kernel API 是否可用。除非该值为 true, 否则不要调用任何其他Kernel属性或方法。 -
Kernel.base:内核基址,以 UInt64 表示。 -
Kernel.pageSize:内核页的大小(字节数),以数字表示。 -
Kernel.enumerateModules():枚举当前已加载的内核模块,返回一个对象数组, 其中每个对象包含以下属性:-
name:规范模块名称,以字符串表示 -
base:基址,以NativePointer表示 -
size:大小(字节数)
-
-
Kernel.enumerateRanges(protection|specifier):枚举满足protection的内核 内存范围。protection是形如rwx的字符串,其中rw-表示“必须至少可读且 可写”。也可以提供specifier对象,其中protection键的值采用上述格式; 如果希望合并具有相同保护属性的相邻范围,则将coalesce键设为true(默认为false,即各范围保持独立)。返回一个对象数组,其中每个对象包含 以下属性:-
base:基址,以NativePointer表示 -
size:大小(字节数) -
protection:保护属性字符串(见上文)
-
-
Kernel.enumerateModuleRanges(name, protection):与Kernel.enumerateRanges类似,但范围限定为指定的name模块;当其值为null时,表示内核本身所在的模块。每个范围还包含一个name字段,其内容是以字符串表示的唯一标识符。 -
Kernel.alloc(size):分配size字节的内核内存,并向上取整为内核页大小的 整数倍。返回值是一个UInt64,用于表示此次分配的基址。 -
Kernel.protect(address, size, protection):更新一段内核内存区域的保护属性, 其中protection的字符串格式与Kernel.enumerateRanges()相同。例如:
Kernel.protect(UInt64('0x1234'), 4096, 'rw-');-
Kernel.readByteArray(address, length):与NativePointer#readByteArray类似,但从内核内存读取。 -
Kernel.writeByteArray(address, bytes):与NativePointer#writeByteArray类似,但写入内核内存。 -
Kernel.readS8(address)、Kernel.readU8(address)、Kernel.readS16(address)、Kernel.readU16(address)、Kernel.readS32(address)、Kernel.readU32(address)、Kernel.readS64(address)、Kernel.readU64(address)、Kernel.readShort(address)、Kernel.readUShort(address)、Kernel.readInt(address)、Kernel.readUInt(address)、Kernel.readLong(address)、Kernel.readULong(address)、Kernel.readFloat(address)、Kernel.readDouble(address): 与相应的NativePointer方法类似,但从address指定的 内核内存中读取;该地址以 UInt64 表示。 -
Kernel.readCString(address, size)、Kernel.readUtf8String(address, size)、Kernel.readUtf16String(address, length): 与相应的NativePointer方法类似,但从内核内存中读取。 请注意,必须提供size/length参数,因为不支持以 NUL 结尾的字符串。 -
Kernel.writeS8(address, value)、Kernel.writeU8(address, value)、Kernel.writeS16(address, value)、Kernel.writeU16(address, value)、Kernel.writeS32(address, value)、Kernel.writeU32(address, value)、Kernel.writeS64(address, value)、Kernel.writeU64(address, value)、Kernel.writeShort(address, value)、Kernel.writeUShort(address, value)、Kernel.writeInt(address, value)、Kernel.writeUInt(address, value)、Kernel.writeLong(address, value)、Kernel.writeULong(address, value)、Kernel.writeFloat(address, value)、Kernel.writeDouble(address, value)、Kernel.writeUtf8String(address, str)、Kernel.writeUtf16String(address, str): 与相应的NativePointer方法类似,但写入address指定的 内核内存;该地址以 UInt64 表示。 -
Kernel.scan(address, size, pattern, callbacks):与Memory.scan类似,但扫描内核内存。 -
Kernel.scanSync(address, size, pattern):scan()的同步版本, 以数组形式返回匹配项。
数据类型、函数与回调
Int64
-
new Int64(v):根据v创建一个新的 Int64;v可以是数字,也可以是包含十进制值的字符串;如果以“0x”开头,则可以是十六进制值。为简洁起见,可以使用int64(v)简写。 -
add(rhs)、sub(rhs)、and(rhs)、or(rhs)、xor(rhs): 创建一个新的 Int64,其值为当前 Int64 与rhs进行加/减/与/或/异或运算的结果;rhs可以是数字或另一个 Int64 -
shr(n)、shl(n): 创建一个新的 Int64,其值为当前 Int64 向右/向左移动n位后的结果 -
not():创建一个新的 Int64,其各个位均为当前 Int64 对应位的取反 -
equals(rhs):返回布尔值,表示rhs是否与当前值相等 -
compare(rhs):返回整数比较结果,行为与 String#localeCompare() 相同 -
toNumber():将此 Int64 转换为数字 -
toString([radix = 10]):转换为字符串,可以指定进制(默认为 10)
UInt64
-
new UInt64(v):根据v创建一个新的 UInt64;v可以是数字,也可以是包含十进制值的字符串;如果以“0x”开头,则可以是十六进制值。为简洁起见,可以使用uint64(v)简写。 -
add(rhs)、sub(rhs)、and(rhs)、or(rhs)、xor(rhs): 创建一个新的 UInt64,其值为当前 UInt64 与rhs进行加/减/与/或/异或运算的结果;rhs可以是数字或另一个 UInt64 -
shr(n)、shl(n): 创建一个新的 UInt64,其值为当前 UInt64 向右/向左移动n位后的结果 -
not():创建一个新的 UInt64,其各个位均为当前 UInt64 对应位的取反 -
equals(rhs):返回布尔值,表示rhs是否与当前值相等 -
compare(rhs):返回整数比较结果,行为与 String#localeCompare() 相同 -
toNumber():将此 UInt64 转换为数字 -
toString([radix = 10]):转换为字符串,可以指定进制(默认为 10)
NativePointer
-
new NativePointer(s):根据字符串s创建一个新的 NativePointer;该字符串包含十进制内存地址,如果以“0x”开头,则包含十六进制地址。为简洁起见,可以使用ptr(s)简写。 -
isNull():返回布尔值,以便检查指针是否为 NULL -
add(rhs)、sub(rhs)、and(rhs)、or(rhs)、xor(rhs): 创建一个新的 NativePointer,其值为当前 NativePointer 与rhs进行加/减/与/或/异或运算的结果;rhs可以是数字或另一个 NativePointer -
shr(n)、shl(n): 创建一个新的 NativePointer,其值为当前 NativePointer 向右/向左移动n位后的结果 -
not():创建一个新的 NativePointer,其各个位均为当前 NativePointer 对应位的取反 -
sign([key, data]):取当前 NativePointer 的各个位并添加指针认证位,创建一个新的 NativePointer(已签名指针)。如果当前进程不支持指针认证,则此操作不执行任何处理,并返回当前 NativePointer,而不是新值。可以选择用字符串指定
key。支持的值为:- ia:IA 密钥,用于签名代码指针。这是默认值。
- ib:IB 密钥,用于签名代码指针。
- da:DA 密钥,用于签名数据指针。
- db:DB 密钥,用于签名数据指针。
还可以将
data参数指定为类似 NativePointer/数字的值,以提供签名所用的额外数据;默认值为0。 -
strip([key]):取当前 NativePointer 的各个位并移除其指针认证位,创建一个新的 NativePointer(原始指针)。如果当前进程不支持指针认证,则此操作不执行任何处理,并返回当前 NativePointer,而不是新值。可以传入
key,指定待剥离指针签名时所用的密钥。默认为ia。(支持的值请参阅sign()。) -
blend(smallInteger):取当前 NativePointer 的各个位并将其与一个常量混合,创建一个新的 NativePointer;得到的值随后可作为data传递给sign()。 -
equals(rhs):返回布尔值,表示rhs是否与当前值相等,即是否具有相同的指针值 -
compare(rhs):返回整数比较结果,行为与 String#localeCompare() 相同 -
toInt32():将此 NativePointer 转换为有符号 32 位整数 -
toUInt32():将此 NativePointer 转换为无符号 32 位整数 -
toString([radix = 16]):转换为字符串,可以指定进制(默认为 16) -
toMatchPattern():返回一个字符串,其中包含与Memory.scan()兼容的匹配模式,用于匹配此指针的原始值 -
readPointer():从此内存位置读取一个NativePointer。如果该地址不可读,将抛出 JavaScript 异常。
-
writePointer(ptr):将ptr写入此内存位置。如果该地址不可写,将抛出 JavaScript 异常。
-
readS8()、readU8()、readS16()、readU16()、readS32()、readU32()、readShort()、readUShort()、readInt()、readUInt()、readFloat()、readDouble(): 从此内存位置读取有符号或无符号 8/16/32 位等整数,或 float/double 值,并以数字形式返回。如果该地址不可读,将抛出 JavaScript 异常。
-
writeS8(value)、writeU8(value)、writeS16(value)、writeU16(value)、writeS32(value)、writeU32(value)、writeShort(value)、writeUShort(value)、writeInt(value)、writeUInt(value)、writeFloat(value)、writeDouble(value): 将有符号或无符号 8/16/32 位等整数,或 float/doublevalue写入此内存位置。如果该地址不可写,将抛出 JavaScript 异常。
-
readS64()、readU64()、readLong()、readULong(): 从此内存位置读取有符号或无符号 64 位值,或 long 大小的值,并以 Int64/UInt64 值返回。如果该地址不可读,将抛出 JavaScript 异常。
-
writeS64(value)、writeU64(value)、writeLong(value)、writeULong(value): 将 Int64/UInt64value写入此内存位置。如果该地址不可写,将抛出 JavaScript 异常。
-
readByteArray(length):从此内存位置读取length个字节,并将其作为 ArrayBuffer 返回。将其作为第二个参数传递给send(),即可高效地把此缓冲区传输到基于 Frida 的应用程序。如果从该地址读取的
length个字节中有任何一个不可读,将抛出 JavaScript 异常。 -
writeByteArray(bytes):将bytes写入此内存位置;bytes可以是 ArrayBuffer(通常由readByteArray()返回),也可以是由 0 到 255 之间的整数组成的数组。例如:[ 0x13, 0x37, 0x42 ]。如果写入该地址的任何字节不可写,将抛出 JavaScript 异常。
-
readVolatile(length)、writeVolatile(bytes):与NativePointer#readByteArray和NativePointer#writeByteArray类似,但会在内存无法访问时避免产生原生异常。这意味着内存访问会更慢,因为涉及一次或多次系统调用;但当 Frida 的原生异常处理失败或不可用,而错误访问最终会导致进程崩溃时,使用它是安全的。如果要在线程可能仍在运行时转储内存,或指针引用了可能已无法访问的内存,请使用此 API。 -
readCString([size = -1])、readUtf8String([size = -1])、readUtf16String([length = -1])、readAnsiString([size = -1]): 将此内存位置上的字节读取为 ASCII、UTF-8、UTF-16 或 ANSI 字符串。如果知道字符串的字节数,请提供可选的size参数;如果字符串以 NUL 结尾,则可省略该参数或指定 -1。同样,如果知道字符串的字符数,也可以提供可选的length参数。如果从该地址读取的
size/length个字节中有任何一个不可读,将抛出 JavaScript 异常。请注意,
readAnsiString()仅在 Windows 上可用(也只有在 Windows 上才有意义)。 -
writeUtf8String(str)、writeUtf16String(str)、writeAnsiString(str): 对 JavaScript 字符串进行编码,并将其写入此内存位置(带 NUL 终止符)。如果写入该地址的任何字节不可写,将抛出 JavaScript 异常。
请注意,
writeAnsiString()仅在 Windows 上可用(也只有在 Windows 上才有意义)。
ArrayBuffer
-
wrap(address, size):创建一个由现有内存区域支持的 ArrayBuffer,其中address是指定该区域基址的NativePointer,size是指定其大小的数字。与NativePointer读写 API 不同,访问时不会执行任何验证,这意味着错误指针会导致进程崩溃。 -
unwrap():返回一个NativePointer,用于指定 ArrayBuffer 后备存储的基址。在后备存储仍被使用期间,调用方有责任让该缓冲区保持存活。
NativeFunction
-
new NativeFunction(address, returnType, argTypes[, abi]):创建一个新的 NativeFunction,用于调用address(通过NativePointer指定)处的函数;returnType指定返回类型,argTypes数组指定参数类型。如果不使用系统默认 ABI,还可以选择指定abi。对于可变参数函数,请在argTypes中的固定参数和可变参数之间添加一个'...'条目。-
按值传递的结构体与类
对于按值传递的结构体或类,请提供一个依次包含结构体各字段类型的数组,而不是字符串。为了表示结构体内嵌套的结构体,可以按需进行任意深度的嵌套。请注意,返回的对象也是
NativePointer,因此可以传递给Interceptor#attach。它必须与结构体/类完全匹配,因此,如果结构体包含三个 int,就必须传入
['int', 'int', 'int']。对于包含虚方法的类,第一个字段将是指向 vtable 的指针。
在 C++ 场景中,如果返回值大于
Process.pointerSize,典型 ABI 可能要求将指向预分配空间的NativePointer作为第一个参数传入。(例如,这种情况在 WebKit 中很常见。) -
支持的类型
- void
- pointer
- int
- uint
- long
- ulong
- char
- uchar
- size_t
- ssize_t
- float
- double
- int8
- uint8
- int16
- uint16
- int32
- uint32
- int64
- uint64
- bool
-
支持的 ABI
- default
- Windows 32-bit:
- sysv
- stdcall
- thiscall
- fastcall
- mscdecl
- Windows 64-bit:
- win64
- UNIX x86:
- sysv
- unix64
- UNIX ARM:
- sysv
- vfp
-
-
new NativeFunction(address, returnType, argTypes[, options]):与前一个构造函数相同,但第四个参数options是一个对象,可以包含以下一个或多个键:-
abi:与上面的枚举相同。 -
scheduling:以字符串指定调度行为。支持的值为:- cooperative:调用原生函数时允许其他线程执行 JavaScript 代码,即调用前释放锁,调用后重新获取锁。这是默认行为。
- exclusive:调用原生函数时不允许其他线程执行 JavaScript 代码,即始终持有 JavaScript 锁。这样速度更快,但可能导致死锁。
-
exceptions:以字符串指定异常行为。支持的值为:- steal:如果被调用函数产生原生异常(例如解引用无效指针),Frida 将展开堆栈并接管该异常,将其转换成可处理的 JavaScript 异常。这可能使应用程序处于未定义状态,但在实验时可用于避免进程崩溃。这是默认行为。
- propagate:让应用程序处理函数调用期间发生的任何原生异常。(或由
Process.setExceptionHandler()安装的处理程序来处理。)
-
traps:以字符串指定要启用的代码陷阱。支持的值为:- default:如果函数调用触发了任何 hook,将调用 Interceptor.attach() 回调。
- none:阻止 Interceptor 和 Stalker 触发。
- all:除 Interceptor 回调外,还可以在每次函数调用期间临时重新激活 Stalker。这适用于在引导模糊测试器时测量代码覆盖率、在调试器中实现“单步进入”等场景。请注意,使用 Java 和 ObjC API 时也可以这样做,因为方法包装器也提供
clone(options)API,用于以自定义 NativeFunction 选项创建新的方法包装器。
-
NativeCallback
-
new NativeCallback(func, returnType, argTypes[, abi]):创建一个由 JavaScript 函数func实现的新 NativeCallback,其中returnType指定返回类型,argTypes数组指定参数类型。如果不使用系统默认 ABI,也可以指定 abi。有关支持的类型和 ABI 的详细信息,请参阅NativeFunction。请注意,返回的对象也是NativePointer,因此可以传递给Interceptor#replace。将生成的回调与 Interceptor.replace() 一起使用时,调用func时会把this绑定到一个包含若干实用属性的对象,与 Interceptor.attach() 中的对象一样。
SystemFunction
-
new SystemFunction(address, returnType, argTypes[, abi]):与NativeFunction相同,但还会提供线程最近一次错误状态的快照。返回值是一个对象,实际返回值封装在value中,并另有一个平台特定字段:UNIX 上名为errno,Windows 上名为lastError。 -
new SystemFunction(address, returnType, argTypes[, options]):与上面相同,但接受类似NativeFunction对应构造函数的options对象。
网络
Socket
-
Socket.listen([options]):打开一个 TCP 或 UNIX 监听套接字。返回一个 Promise,其结果为 SocketListener。如果支持,默认同时监听 IPv4 和 IPv6,并绑定所有接口上随机选择的 TCP 端口。
可选的
options参数是一个对象,可以包含以下部分键:-
family:以字符串指定地址族。支持的值为:- unix
- ipv4
- ipv6
如果支持,默认同时监听
ipv4和ipv6。
-
host:(IP 地址族)以字符串指定 IP 地址。默认为所有接口。 -
port:(IP 地址族)以数字指定 IP 端口。默认为任意可用端口。 -
type:(UNIX 地址族)以字符串指定 UNIX 套接字类型。支持的类型为:- anonymous
- path
- abstract
- abstract-padded
默认为
path。
-
path:(UNIX 地址族)以字符串指定 UNIX 套接字路径。 -
backlog:以数字指定监听积压队列长度。默认为10。
-
-
Socket.connect(options):连接到 TCP 或 UNIX 服务器。返回一个 Promise,其结果为 SocketConnection。options参数是一个对象,应包含以下部分键:-
family:以字符串指定地址族。支持的值为:- unix
- ipv4
- ipv6
默认根据指定的
host选择 IP 地址族。
-
host:(IP 地址族)以字符串指定 IP 地址。默认为localhost。 -
port:(IP 地址族)以数字指定 IP 端口。 -
type:(UNIX 地址族)以字符串指定 UNIX 套接字类型。支持的类型为:- anonymous
- path
- abstract
- abstract-padded
默认为
path。
-
path:(UNIX 地址族)以字符串指定 UNIX 套接字路径。
-
-
Socket.type(handle):检查操作系统套接字handle,并以字符串返回其类型;返回值为tcp、udp、tcp6、udp6、unix:stream、unix:dgram之一;无效或未知时返回null。 -
Socket.localAddress(handle)、Socket.peerAddress(handle): 检查操作系统套接字handle,并返回其本地地址或对端地址;无效或未知时返回null。返回的对象包含以下字段:
-
ip:(IP 套接字)以字符串表示的 IP 地址。 -
port:(IP 套接字)以数字表示的 IP 端口。 -
path:(UNIX 套接字)以字符串表示的 UNIX 路径。
-
SocketListener
所有方法都是完全异步的,并返回 Promise 对象。
-
path:(UNIX 地址族)正在监听的路径。 -
port:(IP 地址族)正在监听的 IP 端口。 -
close():关闭监听器,释放与其相关的资源。监听器关闭后,其他所有操作都会失败。允许多次关闭监听器,且不会产生错误。 -
accept():等待下一个客户端连接。返回的 Promise 的结果为 SocketConnection。
SocketConnection
继承自 IOStream。
所有方法都是完全异步的,并返回 Promise 对象。
-
setNoDelay(noDelay):如果noDelay为true,则禁用 Nagle 算法,否则启用。Nagle 算法默认启用,因此只有希望针对低延迟而非高吞吐量进行优化时,才需要调用此方法。
文件与流
File
-
File.readAllBytes(path):同步读取path指定文件的所有字节,并以ArrayBuffer返回。 -
File.readAllText(path):同步读取path指定文件的所有文本,并以字符串返回。文件必须使用 UTF-8 编码,否则会抛出异常。 -
File.writeAllBytes(path, data):将data同步写入path指定的文件,其中data为ArrayBuffer。 -
File.writeAllText(path, text):将text同步写入path指定的文件,其中text为字符串。文件将使用 UTF-8 编码。 -
new File(filePath, mode):打开或创建位于filePath的文件,字符串mode指定打开方式。例如,使用"wb"以二进制写入模式打开文件(格式与 C 标准库中的fopen()相同)。 -
tell():返回文件指针在文件中的当前位置。 -
seek(offset[, whence]):将文件指针移到新位置。offset是要移至的位置,whence是偏移量的起点(File.SEEK_SET表示文件开头,File.SEEK_CUR表示当前文件位置,File.SEEK_END表示文件末尾)。 -
readBytes([size]):从文件指针当前位置开始读取并返回size个字节,以ArrayBuffer表示。如果未指定size,则从当前位置一直读取到文件末尾。 -
readText([size]):从文件指针当前位置开始读取并返回size个字符,以字符串表示。如果未指定size,则从当前位置一直读取文本到文件末尾。读取的字节必须使用 UTF-8 编码,否则会抛出异常。 -
readLine():读取下一行并以字符串返回。从文件指针当前位置开始读取。返回的行不包含换行符。 -
write(data):将data同步写入文件;data可以是字符串,也可以是NativePointer#readByteArray返回的缓冲区 -
flush():将所有缓冲数据刷新到下层文件。 -
close():关闭文件。文件使用完毕后应调用此函数;如果接受在对象被垃圾回收或脚本卸载时才关闭,则可以不调用。
IOStream
所有方法都是完全异步的,并返回 Promise 对象。
-
input:要读取的 InputStream。 -
output:要写入的 OutputStream。 -
close():关闭流,释放与其相关的资源。这也会关闭各自的输入流和输出流。流关闭后,其他所有操作都会失败。允许多次关闭流,且不会产生错误。
InputStream
所有方法都是完全异步的,并返回 Promise 对象。
-
close():关闭流,释放与其相关的资源。流关闭后,其他所有操作都会失败。允许多次关闭流,且不会产生错误。 -
read(size):从流中读取最多size个字节。返回的 Promise 的结果是一个长度不超过size字节的 ArrayBuffer。空缓冲区表示流结束。 -
readAll(size):持续从流中读取,直到恰好消费size个字节。返回的 Promise 的结果是一个长度恰好为size字节的 ArrayBuffer。如果提前发生错误或流提前结束,Promise 将因错误而被拒绝,其中Error对象的partialData属性包含未完整读取的数据。
OutputStream
所有方法都是完全异步的,并返回 Promise 对象。
-
close():关闭流,释放与其相关的资源。流关闭后,其他所有操作都会失败。允许多次关闭流,且不会产生错误。 -
write(data):尝试将data写入流。data可以是 ArrayBuffer,也可以是由 0 到 255 之间的整数组成的数组。返回的 Promise 的结果是一个 Number,表示写入流中的data字节数。 -
writeAll(data):持续写入流,直到data全部写完。data可以是 ArrayBuffer,也可以是由 0 到 255 之间的整数组成的数组。如果提前发生错误或流提前结束,将产生错误,其中Error对象的partialSize属性表示错误发生前已写入流中的data字节数。 -
writeMemoryRegion(address, size):尝试将size个字节写入流;这些字节从address读取,address是一个NativePointer。返回的 Promise 的结果是一个 Number,表示写入流中的data字节数。
UnixInputStream
(仅在类 UNIX 操作系统上可用。)
-
new UnixInputStream(fd[, options]):根据指定的文件描述符fd创建一个新的 InputStream。还可以提供一个
autoClose设为true的options对象,让流在通过close()或未来的垃圾回收被释放时,关闭下层文件描述符。
UnixOutputStream
(仅在类 UNIX 操作系统上可用。)
-
new UnixOutputStream(fd[, options]):根据指定的文件描述符fd创建一个新的 OutputStream。还可以提供一个
autoClose设为true的options对象,让流在通过close()或未来的垃圾回收被释放时,关闭下层文件描述符。
Win32InputStream
(仅在 Windows 上可用。)
-
new Win32InputStream(handle[, options]):根据指定的handle创建一个新的 InputStream,其中handle是 Windows HANDLE 值。还可以提供一个
autoClose设为true的options对象,让流在通过close()或未来的垃圾回收被释放时,关闭下层句柄。
Win32OutputStream
(仅在 Windows 上可用。)
-
new Win32OutputStream(handle[, options]):根据指定的handle创建一个新的 OutputStream,其中handle是 Windows HANDLE 值。还可以提供一个
autoClose设为true的options对象,让流在通过close()或未来的垃圾回收被释放时,关闭下层句柄。
数据库
SqliteDatabase
-
SqliteDatabase.open(path[, options]):打开path指定的 SQLite v3 数据库;path是包含数据库文件系统路径的字符串。默认以读写方式打开数据库,但可以提供带有flags属性的options对象来自定义此行为;flags是一个字符串数组,包含以下一个或多个值:readonly、readwrite、create。返回的 SqliteDatabase 对象可用于查询数据库。 -
SqliteDatabase.openInline(encodedContents):与open()类似,但数据库内容通过包含其数据的 Base64 编码字符串提供。建议先对数据库进行 gzip 压缩,再执行 Base64 编码;这一步是可选的,系统会通过检查 gzip 魔数来自动检测。数据库以读写方式打开,但完全位于内存中,绝不访问文件系统。对于需要捆绑预计算数据缓存的 agent(例如用于指导动态分析的静态分析数据),这很有用。 -
close():关闭数据库。数据库使用完毕后应调用此函数;如果接受在对象被垃圾回收或脚本卸载时才关闭,则可以不调用。 -
exec(sql):执行原始 SQL 查询,其中sql是包含查询文本表示形式的字符串。查询结果会被忽略,因此只能用于设置数据库的查询,例如创建表。 -
prepare(sql):将所提供的 SQL 编译为 SqliteStatement 对象,其中sql是包含查询文本表示形式的字符串。例如:
const db = SqliteDatabase.open('/path/to/people.db');

const smt = db.prepare('SELECT name, bio FROM people WHERE age = ?');

console.log('People whose age is 42:');
smt.bindInteger(1, 42);
let row;
while ((row = smt.step()) !== null) {
  const [name, bio] = row;
  console.log('Name:', name);
  console.log('Bio:', bio);
}
smt.reset();-
dump():将数据库转储为经 gzip 压缩并以 Base64 编码的 blob,结果以字符串返回。这适用于在 agent 代码中内联缓存,并通过调用SqliteDatabase.openInline()加载。
SqliteStatement
-
columnNames:字符串数组,包含预备语句中的列名 -
columnTypes:字符串数组,包含当前结果行中各值的类型,每个值为integer、float、text、blob或null之一。只有在step()返回一行后才有意义,因为 SQLite 列类型可能随结果行而变化。 -
declaredTypes:数组,包含表结构中指定的列声明类型;每项可以是TEXT或INTEGER等字符串,如果该列没有声明类型(例如表达式列),则为null -
paramsCount:预备语句中的 SQL 参数数量 -
bindInteger(index, value):将整数value绑定到index -
bindFloat(index, value):将浮点value绑定到index -
bindText(index, value):将文本value绑定到index -
bindBlob(index, bytes):将 blobbytes绑定到index,其中bytes是 ArrayBuffer、字节值数组或字符串 -
bindNull(index):将 null 值绑定到index -
step():开始新查询并取得第一个结果,或移至下一个结果。返回一个数组,其中包含按查询所指定顺序排列的值;到达最后一个结果时返回null。如果之后还要再次使用此对象,此时应调用reset()。 -
reset():重置内部状态,以允许后续查询
插桩
Interceptor
-
Interceptor.attach(target, callbacks[, data]):拦截对target处函数的调用。target是一个NativePointer,指定要拦截调用的函数地址。请注意,在 32 位 ARM 上,对于 ARM 函数,此地址的最低有效位必须为 0;对于 Thumb 函数,则必须为 1。如果通过 Frida API 获取地址(例如Module#getExportByName()),Frida 会替你处理这一细节。target也可以是一个带有target属性(包含地址)及一个或多个插桩选项的对象,这些选项控制内联 hook 的设置方式。replace()和replaceFast()也是如此。callbacks参数是一个包含以下一个或多个成员的对象:-
onEnter(args):回调函数,接收一个参数args,可将其作为NativePointer对象数组来读写参数。 -
onLeave(retval):回调函数,接收一个参数retval;这是一个派生自NativePointer的对象,包含原始返回值。 可以调用retval.replace(1337),将返回值替换为整数1337;也可以调用retval.replace(ptr("0x1234")),将其替换为指针。 请注意,此对象会在多次 onLeave 调用之间循环复用,因此不要将其保存后在回调外使用。如果需要保存其中的值,请创建深层副本,例如:ptr(retval.toString())。
如果被 hook 的函数调用频率很高,
onEnter和onLeave可以是指向使用 CModule 编译的原生 C 函数的NativePointer值。它们的签名为:-
void onEnter (GumInvocationContext * ic) -
void onLeave (GumInvocationContext * ic)
在这种情况下,第三个可选参数
data可以是一个NativePointer,可通过gum_invocation_context_get_listener_function_data()访问。还可以传入一个函数而不是
callbacks对象,以拦截任意指令。该函数的签名与onEnter相同,但只有当被拦截的指令位于函数开头,或寄存器/堆栈尚未偏离该位置时,传给它的args参数才会提供有意义的值。与上面相同,也可以指定一个
NativePointer而不是函数,从而用 C 实现此函数。返回一个监听器对象,可对其调用
detach()。请注意,调用这些函数时,
this会绑定到一个按调用创建(线程局部)的对象,可以在其中存储任意数据。如果希望在onEnter中读取参数,并在onLeave中对其进行处理,这一点很有用。例如:
-
const libc = Process.getModuleByName('libc.so');
Interceptor.attach(libc.getExportByName('read'), {
  onEnter(args) {
    this.fileDescriptor = args[0].toInt32();
  },
  onLeave(retval) {
    if (retval.toInt32() > 0) {
      /* do something with this.fileDescriptor */
    }
  }
});-
此外,该对象还包含一些实用属性:
-
returnAddress:以 NativePointer 表示的返回地址 -
context:包含pc和sp键的对象;对于 ia32/x64/arm,它们分别是指定 EIP/RIP/PC 和 ESP/RSP/SP 的 NativePointer 对象。还提供其他处理器特定的键,例如eax、rax、r0、x0等。 也可以通过为这些键赋值来更新寄存器值。 -
errno:(UNIX)当前 errno 值(可以替换) -
lastError:(Windows)当前操作系统错误值(可以替换) -
threadId:操作系统线程 ID -
depth:相对于其他调用的调用深度
例如:
-
Interceptor.attach(Module.getGlobalExportByName('read'), {
  onEnter(args) {
    console.log('Context information:');
    console.log('Context  : ' + JSON.stringify(this.context));
    console.log('Return   : ' + this.returnAddress);
    console.log('ThreadId : ' + this.threadId);
    console.log('Depth    : ' + this.depth);
    console.log('Errornr  : ' + this.err);

    // Save arguments for processing in onLeave.
    this.fd = args[0].toInt32();
    this.buf = args[1];
    this.count = args[2].toInt32();
  },
  onLeave(result) {
    console.log('----------')
    // Show argument 1 (buf), saved during onEnter.
    const numBytes = result.toInt32();
    if (numBytes > 0) {
      console.log(hexdump(this.buf, { length: numBytes, ansi: true }));
    }
    console.log('Result   : ' + numBytes);
  }
})
性能注意事项
所提供的回调会对性能产生显著影响。如果只需要检查参数而不关心返回值,或情况正好相反,请务必省略不需要的回调;也就是说,不要把逻辑放在 onEnter 中,却又保留一个空的 onLeave 回调。
在 iPhone 5S 上,仅提供 onEnter 时的基础开销可能约为 6 微秒,同时提供 onEnter 和 onLeave 时则约为 11 微秒。
还要谨慎拦截每秒调用无数次的函数;虽然 send() 是异步的,但发送单条消息的总开销并未针对高频率优化。因此,Frida 会让你根据需要低延迟还是高吞吐量,自行将多个值批量放入一次 send() 调用中。
不过,在 hook 高频函数时,可以结合使用 Interceptor 和 CModule,用 C 实现回调。
-
Interceptor.detachAll():分离此前附加的所有回调。 -
Interceptor.replace(target, replacement[, data]):用replacement处的实现替换target处的函数。通常用于完全或部分替换现有函数的实现。使用
NativeCallback以 JavaScript 实现replacement。如果被替换函数的调用频率很高,可以使用 CModule 以 C 实现
replacement。还可以指定第三个可选参数data;它是一个NativePointer,可通过gum_invocation_context_get_listener_function_data()访问。使用gum_interceptor_get_current_invocation()可取得GumInvocationContext *。请注意,在调用
Interceptor#revert之前,replacement会一直保持存活。如果要链接到原始实现,可以在自己的实现中通过
NativeFunction同步调用target;这会绕过替换,直接调用原始实现。示例:
const libc = Process.getModuleByName('libc.so');
const openPtr = libc.getExportByName('open');
const open = new NativeFunction(openPtr, 'int', ['pointer', 'int']);
Interceptor.replace(openPtr, new NativeCallback((pathPtr, flags) => {
  const path = pathPtr.readUtf8String();
  log('Opening "' + path + '"');
  const fd = open(pathPtr, flags);
  log('Got fd: ' + fd);
  return fd;
}, 'int', ['pointer', 'int']));-
Interceptor.replaceFast(target, replacement):与replace()类似,但会修改target,使其直接跳转到替换实现,因此开销比 replace() 更低。这也意味着,如果要调用原始实现,必须使用返回的指针。 -
Interceptor.revert(target):将target处的函数恢复为此前的实现。 -
Interceptor.flush():确保所有待处理更改都已提交到内存。只应在少数确有必要的情况下这样做,例如刚对即将通过 NativeFunction 调用的函数执行 attach() 或 replace()。每当当前线程即将离开 JavaScript 运行时或调用 send() 时,待处理更改都会自动刷新。这包括任何构建于 send() 之上的 API,例如从 RPC 方法返回,以及调用 console API 上的任何方法。 -
Interceptor.breakpointKind:字符串,指定非内联 hook 使用的断点类型。仅在 Barebone 后端中可用。默认为
'soft',即软件断点。设为'hard'可使用硬件断点。 -
Interceptor.defaults:包含默认插桩选项的对象,这些选项会应用到之后的每次attach()、replace()和replaceFast()调用。每次调用单独指定的选项优先于这些默认值。
插桩选项如下:
-
scratchRegister:Interceptor 在构建 trampoline 时可以破坏的寄存器名称,例如x16。仅在公开暂存寄存器的架构上受支持,即 arm64 和 mips。 -
scenario:字符串,指定插桩期间是否可能有其他线程正在执行目标。调用可能正在进行时使用online,即某个线程可能已经执行了具有调用语义的指令(CALL/BL 等),但尚未返回。不会发生这种情况时使用offline,例如生成进程之后、恢复进程之前,或者在你控制的某个外部输入到来前不会发生调用时。offline场景允许写入超出此类指令末尾的位置,而在线状态下这样做并不安全。默认为online。 -
relocation:字符串,指定如何处理被 hook 覆盖的指令的重定位,可取:-
checked:验证所选暂存寄存器没有在函数早期序言中使用、不存在跳回被覆盖指令的分支,并检查类似约束。这是默认值。 -
unchecked:跳过这些检查。 -
forced:与unchecked类似,但还允许覆盖到函数末尾之后;适用于明确知道这样做安全的情况,例如当前函数与下一个函数之间存在对齐填充。
-
-
writeRedirect(details):回调函数,用于从被插桩的函数或指令向 Interceptor 的 trampoline 发出自定义重定向。主要用途是规避指纹识别:发出一个 RASP 实现无法识别为内联 hook 的重定向。在空间紧张时,它也很有用:可以找到一个通过短分支能够到达的附近代码洞,再从那里跳转到更远处的 trampoline。details参数是一个包含以下成员的对象:-
writer:用于发出重定向的代码写入器,例如 x86 上的 X86Writer 和 arm64 上的 Arm64Writer。在 32 位 ARM 上,根据插桩位置的指令集,它可以是 ArmWriter 或 ThumbWriter。 -
target:Interceptor trampoline 的地址,即重定向应跳转到的位置,以NativePointer表示 -
scratchRegister:重定向可以破坏的寄存器名称。仅在 arm64 和 mips 上存在。 -
capacity:重定向可用的字节数
从回调中抛出异常表示拒绝该重定向。在这种情况下不会回退到默认策略,因此
attach()、replace()或replaceFast()调用会失败,就像目标无法被插桩一样。 -
-
redirectSpaceHint:writeRedirect所需字节数的上限。回调最终可能使用更少的空间。指定较大的值意味着 Interceptor 必须进行更深入的探索,以确定使用这么多空间是安全的——查找反向分支、调用返回位置等——因此开销更高。默认为完整重定向所需的大小,例如 arm64 上为 16 字节。
例如,在 arm64 上:
const open = Module.getGlobalExportByName('open');
Interceptor.attach({
  target: open,
  writeRedirect({ writer, target, scratchRegister }) {
    writer.putLdrRegAddress(scratchRegister, target);
    writer.putBrReg(scratchRegister);
  }
}, {
  onEnter(args) {
    console.log('open:', args[0].readUtf8String());
  }
});
Stalker
-
Stalker.exclude(range):将指定的内存range标记为排除范围。它是一个具有base和size属性的对象,与Process.getModuleByName()等方法返回的对象中的同名属性类似。这意味着,当遇到对此范围内指令的调用时,Stalker 不会继续跟踪其执行。因此,你可以 观察或修改传入的参数以及返回值,但看不到二者之间执行的指令。
这有助于提升性能并减少干扰信息。
-
Stalker.follow([threadId, options]):开始跟踪threadId(省略时为当前线程), 还可通过可选的options启用事件。例如:
const mainThread = Process.enumerateThreads()[0];

Stalker.follow(mainThread.id, {
  events: {
    call: true, // CALL instructions: yes please

    // Other events:
    ret: false, // RET instructions
    exec: false, // all instructions: not recommended as it's
                 //                   a lot of data
    block: false, // block executed: coarse execution trace
    compile: false // block compiled: useful for coverage
  },

  //
  // Only specify one of the two following callbacks.
  // (See note below.)
  //

  //
  // onReceive: Called with `events` containing a binary blob
  //            comprised of one or more GumEvent structs.
  //            See `gumevent.h` for details about the
  //            format. Use `Stalker.parse()` to examine the
  //            data.
  //
  //onReceive(events) {
  //},
  //

  //
  // onCallSummary: Called with `summary` being a key-value
  //                mapping of call target to number of
  //                calls, in the current time window. You
  //                would typically implement this instead of
  //                `onReceive()` for efficiency, i.e. when
  //                you only want to know which targets were
  //                called and how many times, but don't care
  //                about the order that the calls happened
  //                in.
  //
  onCallSummary(summary) {
  },

  //
  // Advanced users: This is how you can plug in your own
  //                 StalkerTransformer, where the provided
  //                 function is called synchronously
  //                 whenever Stalker wants to recompile
  //                 a basic block of the code that's about
  //                 to be executed by the stalked thread.
  //
  //transform(iterator) {
  //  let instruction = iterator.next();
  //
  //  const startAddress = instruction.address;
  //  const isAppCode = startAddress.compare(appStart) >= 0 &&
  //      startAddress.compare(appEnd) === -1;
  //
  //  /*
  //   * Need to be careful on ARM/ARM64 as we may disturb instruction sequences
  //   * that deal with exclusive stores.
  //   */
  //  const canEmitNoisyCode = iterator.memoryAccess === 'open';
  //
  //  do {
  //    if (isAppCode && canEmitNoisyCode && instruction.mnemonic === 'ret') {
  //      iterator.putCmpRegI32('eax', 60);
  //      iterator.putJccShortLabel('jb', 'nope', 'no-hint');
  //
  //      iterator.putCmpRegI32('eax', 90);
  //      iterator.putJccShortLabel('ja', 'nope', 'no-hint');
  //
  //      iterator.putCallout(onMatch);
  //
  //      iterator.putLabel('nope');
  //
  //      /* You may also use putChainingReturn() to insert an early return. */
  //    }
  //
  //    iterator.keep();
  //  } while ((instruction = iterator.next()) !== null);
  //},
  //
  // The default implementation is just:
  //
  //   while (iterator.next() !== null)
  //     iterator.keep();
  //
  // The example above shows how you can insert your own code
  // just before every `ret` instruction across any code
  // executed by the stalked thread inside the app's own
  // memory range. It inserts code that checks if the `eax`
  // register contains a value between 60 and 90, and inserts
  // a synchronous callout back into JavaScript whenever that
  // is the case. The callback receives a single argument
  // that gives it access to the CPU registers, and it is
  // also able to modify them.
  //
  // function onMatch (context) {
  //   console.log('Match! pc=' + context.pc +
  //       ' rax=' + context.rax.toInt32());
  // }
  //
  // Note that not calling keep() will result in the
  // instruction getting dropped, which makes it possible
  // for your transform to fully replace certain instructions
  // when this is desirable.
  //

  //
  // Want better performance? Write the callbacks in C:
  //
  // /*
  //  * const cm = new CModule(\`
  //  *
  //  * #include <gum/gumstalker.h>
  //  *
  //  * static void on_ret (GumCpuContext * cpu_context,
  //  *     gpointer user_data);
  //  *
  //  * void
  //  * transform (GumStalkerIterator * iterator,
  //  *            GumStalkerOutput * output,
  //  *            gpointer user_data)
  //  * {
  //  *   cs_insn * insn;
  //  *
  //  *   while (gum_stalker_iterator_next (iterator, &insn))
  //  *   {
  //  *     if (insn->id == X86_INS_RET)
  //  *     {
  //  *       gum_x86_writer_put_nop (output->writer.x86);
  //  *       gum_stalker_iterator_put_callout (iterator,
  //  *           on_ret, NULL, NULL);
  //  *     }
  //  *
  //  *     gum_stalker_iterator_keep (iterator);
  //  *   }
  //  * }
  //  *
  //  * static void
  //  * on_ret (GumCpuContext * cpu_context,
  //  *         gpointer user_data)
  //  * {
  //  *   printf ("on_ret!\n");
  //  * }
  //  *
  //  * void
  //  * process (const GumEvent * event,
  //  *          GumCpuContext * cpu_context,
  //  *          gpointer user_data)
  //  * {
  //  *   switch (event->type)
  //  *   {
  //  *     case GUM_CALL:
  //  *       break;
  //  *     case GUM_RET:
  //  *       break;
  //  *     case GUM_EXEC:
  //  *       break;
  //  *     case GUM_BLOCK:
  //  *       break;
  //  *     case GUM_COMPILE:
  //  *       break;
  //  *     default:
  //  *       break;
  //  *   }
  //  * }
  //  * `);
  //  */
  //
  //transform: cm.transform,
  //onEvent: cm.process,
  //data: ptr(1337) /* user_data */
  //
  // You may also use a hybrid approach and only write
  // some of the callouts in C.
  //
});
性能注意事项
所提供的回调会对性能产生显著影响。如果只需要定期生成调用摘要而不关心原始事件, 或者情况正好相反,请务必省略不需要的回调。例如,不要把逻辑放在 onCallSummary 中,却又保留一个空的 onReceive 回调。
另请注意,Stalker 可以与 CModule 结合使用,这意味着回调可以使用 C 实现。
-
Stalker.unfollow([threadId]):停止跟踪threadId(省略时为当前线程)。 -
Stalker.parse(events[, options]):解析 GumEvent 二进制数据块,并可选择通过options自定义输出。例如:
  onReceive(events) {
    console.log(Stalker.parse(events, {
      annotate: true, // to display the type of event
      stringify: true
        // to format pointer values as strings instead of `NativePointer`
        // values, i.e. less overhead if you're just going to `send()` the
        // thing not actually parse the data agent-side
    }));
},-
Stalker.flush():刷新所有缓冲的事件。当你不想等到下一个Stalker.queueDrainInterval周期时很有用。 -
Stalker.garbageCollect():在Stalker#unfollow之后的 安全时机释放累积的内存。这样做是为了避免刚停止跟踪的线程仍在执行最后几条指令而产生 竞态条件。 -
Stalker.invalidate(address):使当前线程针对给定基本块生成的已转换代码失效。 当你提供了转换回调,并希望动态调整给定基本块的插桩时,此方法很有用。它比停止跟踪后 再重新跟踪线程高效得多;后者会丢弃所有缓存的转换结果,并要求从头编译遇到的所有基本块。 -
Stalker.invalidate(threadId, address):使指定线程针对给定基本块生成的已转换代码失效。 当你提供了转换回调,并希望动态调整给定基本块的插桩时,此方法很有用。它比停止跟踪后 再重新跟踪线程高效得多;后者会丢弃所有缓存的转换结果,并要求从头编译遇到的所有基本块。 -
Stalker.addCallProbe(address, callback[, data]):当调用address时同步调用callback(签名请参阅Interceptor#attach#onEnter)。 返回一个 ID,稍后可将其传给Stalker#removeCallProbe。也可以借助 CModule 使用 C 实现
callback:指定一个NativePointer而不是函数。其签名为:void onCall (GumCallSite * site, gpointer user_data)
在这种情况下,第三个可选参数
data可以是一个NativePointer, 其值会作为user_data传给回调。 -
Stalker.removeCallProbe:移除由Stalker#addCallProbe添加的调用探针。 -
Stalker.trustThreshold:一个整数,指定一段代码需要执行多少次,才会被认为可信且不会改变。 指定 -1 表示不信任(速度较慢),指定 0 表示从一开始就信任代码,指定 N 表示执行 N 次后 信任代码。默认值为 1。 -
Stalker.queueCapacity:一个整数,以事件数量指定事件队列的容量。默认值为 16384 个事件。 -
Stalker.queueDrainInterval:一个整数,以毫秒为单位指定两次事件队列排空之间的时间。 默认值为 250 ms,即每秒排空事件队列四次。也可以将此属性设为零以禁用定期排空, 并在希望排空队列时改为调用Stalker.flush()。
ObjC
已迁移
从 Frida 17 开始,此运行时桥接不再内置于 Frida 的 GumJS 运行时中,
可通过运行以下命令获取:npm install frida-objc-bridge。
按以下方式将其导入你的 agent:
import ObjC from 'frida-objc-bridge';
目前,由 Frida REPL 和 frida-trace 加载的脚本不需要这样做。
-
ObjC.available:一个布尔值,指定当前进程是否已加载 Objective-C 运行时。 只有在值为真时,才能调用其他ObjC属性或方法。 -
ObjC.api:一个将函数名称映射到NativeFunction实例的对象, 用于直接访问 Objective-C 运行时 API 的很大一部分。 -
ObjC.classes:一个将类名映射到ObjC.ObjectJavaScript 绑定的对象, 其中包含当前注册的每个类。可以使用点号表示法与对象交互,并将冒号替换为下划线,例如:[NSString stringWithString:@"Hello World"]会变为const { NSString } = ObjC.classes; NSString.stringWithString_("Hello World");. 请注意方法名后的下划线。更多详情请参阅 iOS 示例一节。 -
ObjC.protocols:一个将协议名映射到ObjC.ProtocolJavaScript 绑定的对象,其中包含当前注册的每个协议。 -
ObjC.mainQueue:主线程的 GCD 队列。 -
ObjC.schedule(queue, work):将 JavaScript 函数work调度到queue指定的 GCD 队列上。系统会在调用work之前创建一个NSAutoreleasePool,并在返回时清理它。
const { NSSound } = ObjC.classes; /* macOS */
ObjC.schedule(ObjC.mainQueue, () => {
    const sound = NSSound.alloc().initWithContentsOfFile_byReference_("/Users/oleavr/.Trash/test.mp3", true);
    sound.play();
});-
new ObjC.Object(handle[, protocol]):为handle处的现有对象(一个 NativePointer)创建 JavaScript 绑定。 如果希望仅把handle视为实现某个特定协议的对象,也可以指定protocol参数。
Interceptor.attach(myFunction.implementation, {
  onEnter(args) {
    // ObjC: args[0] = self, args[1] = selector, args[2-n] = arguments
    const myString = new ObjC.Object(args[2]);
    console.log("String argument: " + myString.toString());
  }
});
此对象具有一些特殊属性:
$kind:字符串,值为instance、class或meta-class$super:一个 ObjC.Object 实例,用于向上链接到超类方法实现$superClass:以 ObjC.Object 实例表示的超类$class:以 ObjC.Object 实例表示的此对象所属类$className:包含此对象类名的字符串$moduleName:包含此对象模块路径的字符串$protocols:一个对象,将此对象遵循的每个协议的协议名映射到ObjC.Protocol实例$methods:包含此对象所属类及其父类公开的原生方法名的数组$ownMethods:包含此对象所属类公开的原生方法名的数组,不包括父类$ivars:将每个实例变量名映射到其当前值的对象,可通过访问和赋值来读写各个变量另有一个
equals(other)方法,用于检查两个实例是否引用同一个底层对象。请注意,所有方法包装器都提供
clone(options)API,用于创建带有自定义 NativeFunction 选项的新方法包装器。
-
new ObjC.Protocol(handle):为handle处的现有协议(一个 NativePointer)创建 JavaScript 绑定。 -
new ObjC.Block(target[, options]):为target处的现有 block(一个 NativePointer)创建 JavaScript 绑定。若要定义新 block,target应为一个对象,其中指定类型签名,以及每次调用该 block 时要调用的 JavaScript 函数。函数通过implementation键指定;签名则通过types键,或通过retType与argTypes键指定。详情请参阅ObjC.registerClass()。请注意,如果现有 block 缺少签名元数据,可以调用
declare(signature);如上所述,signature是一个包含types键,或者包含retType和argTypes键的对象。还可以提供
options对象,其选项与 NativeFunction 支持的选项相同。 例如,传入traps: 'all',以便在调用 block 时通过Stalker.follow()跟踪其执行。最常见的用例是 hook 现有 block。对于一个需要两个参数的 block,大致如下:
const pendingBlocks = new Set();

Interceptor.attach(..., {
  onEnter(args) {
    const block = new ObjC.Block(args[4]);
    pendingBlocks.add(block); // Keep it alive
    const appCallback = block.implementation;
    block.implementation = (error, value) => {
      // Do your logging here
      const result = appCallback(error, value);
      pendingBlocks.delete(block);
      return result;
    };
  }
});-
ObjC.implement(method, fn):创建与method签名兼容的 JavaScript 实现, 并以 JavaScript 函数fn作为实现。返回一个NativeCallback, 可将其赋给 ObjC 方法的implementation属性。
const NSSound = ObjC.classes.NSSound; /* macOS */
const oldImpl = NSSound.play.implementation;
NSSound.play.implementation = ObjC.implement(NSSound.play, (handle, selector) => {
  return oldImpl(handle, selector);
});

const NSView = ObjC.classes.NSView; /* macOS */
const drawRect = NSView['- drawRect:'];
const oldImpl = drawRect.implementation;
drawRect.implementation = ObjC.implement(drawRect, (handle, selector) => {
  oldImpl(handle, selector);
});
由于
implementation属性是一个NativeFunction,因而也是一个NativePointer,所以还可以使用Interceptorhook 函数:
const { NSSound } = ObjC.classes; /* macOS */
Interceptor.attach(NSSound.play.implementation, {
  onEnter() {
    send("[NSSound play]");
  }
});-
ObjC.registerProxy(properties):创建一个充当目标对象代理的新类,其中properties是一个用于指定以下内容的对象:-
protocols:(可选)此类遵循的协议数组。 -
methods:(可选)指定要实现的方法的对象。 -
events:(可选)指定接收事件通知所用回调的对象:-
dealloc():在对象被释放后立即调用。可在此清理所有关联状态。 -
forward(name):在即将转发调用时调用,name指定方法名。可以先在这里使用 一个只记录名称的临时回调,以帮助你决定要覆盖哪些方法。
-
-
const MyConnectionDelegateProxy = ObjC.registerProxy({
  protocols: [ObjC.protocols.NSURLConnectionDataDelegate],
  methods: {
    '- connection:didReceiveResponse:': function (conn, resp) {
      /* fancy logging code here */
      /* this.data.foo === 1234 */
      this.data.target
          .connection_didReceiveResponse_(conn, resp);
    },
    '- connection:didReceiveData:': function (conn, data) {
      /* other logging code here */
      this.data.target
          .connection_didReceiveData_(conn, data);
    }
  },
  events: {
    forward(name) {
      console.log('*** forwarding: ' + name);
    }
  }
});

const method = ObjC.classes.NSURLConnection[
    '- initWithRequest:delegate:startImmediately:'];
Interceptor.attach(method.implementation, {
  onEnter(args) {
    args[3] = new MyConnectionDelegateProxy(args[3], {
      foo: 1234
    });
  }
});-
ObjC.registerClass(properties):创建一个新的 Objective-C 类,其中properties是一个用于指定以下内容的对象:-
name:(可选)指定类名的字符串。如果不关心全局可见名称,并希望由运行时自动生成, 请省略此项。 -
super:(可选)超类;设为 null 可创建新的根类。省略时继承 NSObject。 -
protocols:(可选)此类遵循的协议数组。 -
methods:(可选)指定要实现的方法的对象。
-
const MyConnectionDelegateProxy = ObjC.registerClass({
  name: 'MyConnectionDelegateProxy',
  super: ObjC.classes.NSObject,
  protocols: [ObjC.protocols.NSURLConnectionDataDelegate],
  methods: {
    '- init': function () {
      const self = this.super.init();
      if (self !== null) {
        ObjC.bind(self, {
          foo: 1234
        });
      }
      return self;
    },
    '- dealloc': function () {
      ObjC.unbind(this.self);
      this.super.dealloc();
    },
    '- connection:didReceiveResponse:': function (conn, resp) {
      /* this.data.foo === 1234 */
    },
    /*
     * But those previous methods are declared assuming that
     * either the super-class or a protocol we conform to has
     * the same method so we can grab its type information.
     * However, if that's not the case, you would write it
     * like this:
     */
    '- connection:didReceiveResponse:': {
      retType: 'void',
      argTypes: ['object', 'object'],
      implementation(conn, resp) {
      }
    },
    /* Or grab it from an existing class: */
    '- connection:didReceiveResponse:': {
      types: ObjC.classes
          .Foo['- connection:didReceiveResponse:'].types,
      implementation(conn, resp) {
      }
    },
    /* Or from an existing protocol: */
    '- connection:didReceiveResponse:': {
      types: ObjC.protocols.NSURLConnectionDataDelegate
          .methods['- connection:didReceiveResponse:'].types,
      implementation(conn, resp) {
      }
    },
    /* Or write the signature by hand if you really want to: */
    '- connection:didReceiveResponse:': {
      types: 'v32@0:8@16@24',
      implementation(conn, resp) {
      }
    }
  }
});

const proxy = MyConnectionDelegateProxy.alloc().init();
/* use `proxy`, and later: */
proxy.release();-
ObjC.registerProtocol(properties):创建一个新的 Objective-C 协议,其中properties是一个用于指定以下内容的对象:-
name:(可选)指定协议名的字符串。如果不关心全局可见名称,并希望由运行时自动生成, 请省略此项。 -
protocols:(可选)此协议纳入的协议数组。 -
methods:(可选)指定要声明的方法的对象。
-
const MyDataDelegate = ObjC.registerProtocol({
  name: 'MyDataDelegate',
  protocols: [ObjC.protocols.NSURLConnectionDataDelegate],
  methods: {
    /* You must specify the signature: */
    '- connection:didStuff:': {
      retType: 'void',
      argTypes: ['object', 'object']
    },
    /* Or grab it from a method of an existing class: */
    '- connection:didStuff:': {
      types: ObjC.classes
          .Foo['- connection:didReceiveResponse:'].types
    },
    /* Or from an existing protocol method: */
    '- connection:didStuff:': {
      types: ObjC.protocols.NSURLConnectionDataDelegate
          .methods['- connection:didReceiveResponse:'].types
    },
    /* Or write the signature by hand if you really want to: */
    '- connection:didStuff:': {
      types: 'v32@0:8@16@24'
    },
    /* You can also make a method optional (default is required): */
    '- connection:didStuff:': {
      retType: 'void',
      argTypes: ['object', 'object'],
      optional: true
    }
  }
});-
ObjC.bind(obj, data):将一些 JavaScript 数据绑定到 Objective-C 实例;示例请参阅ObjC.registerClass()。 -
ObjC.unbind(obj):解除 Objective-C 实例先前关联的 JavaScript 数据;示例请参阅ObjC.registerClass()。 -
ObjC.getBoundData(obj):从 Objective-C 对象中查找之前绑定的数据。 -
ObjC.enumerateLoadedClasses([options, ]callbacks):枚举当前已加载的类,其中callbacks是一个用于指定以下内容的对象:-
onMatch(name, owner):针对每个已加载的类调用;name是字符串形式的类名,owner指定加载该类的模块路径。要获取给定类的 JavaScript 包装器,请使用:ObjC.classes[name]。 -
onComplete():枚举完所有类后调用。
例如:
-
ObjC.enumerateLoadedClasses({
  onMatch(name, owner) {
    console.log('onMatch:', name, owner);
  },
  onComplete() {
  }
});
可选的 options 参数是一个对象,可以在其中指定 ownedBy 属性,将枚举范围限制为给定
ModuleMap 中的模块。
例如:
const appModules = new ModuleMap(isAppModule);
ObjC.enumerateLoadedClasses({ ownedBy: appModules }, {
  onMatch(name, owner) {
    console.log('onMatch:', name, owner);
  },
  onComplete() {
  }
});

function isAppModule(m) {
  return !/^\/(usr\/lib|System|Developer)\//.test(m.path);
}-
ObjC.enumerateLoadedClassesSync([options]):enumerateLoadedClasses()的同步版本,返回一个将 所属模块映射到类名数组的对象。例如:
const appModules = new ModuleMap(isAppModule);
const appClasses = ObjC.enumerateLoadedClassesSync({ ownedBy: appModules });
console.log('appClasses:', JSON.stringify(appClasses));

function isAppModule(m) {
  return !/^\/(usr\/lib|System|Developer)\//.test(m.path);
}-
ObjC.choose(specifier, callbacks):通过扫描堆,枚举与specifier匹配的类的活动实例。specifier可以是类选择器,也可以是一个指定类选择器及所需选项的对象。类选择器是表示类的 ObjC.Object,例如 ObjC.classes.UIButton。 以对象作为 specifier 时,应通过class字段提供类选择器,并通过subclasses字段 提供一个布尔值,指明是否也希望匹配给定类选择器的子类。默认也会包含子类。callbacks参数是一个用于指定以下内容的对象:-
onMatch(instance):针对找到的每个活动实例调用一次,并提供可直接使用的instance, 就像你已知某个 Objective-C 实例位于 0x1234,并调用了new ObjC.Object(ptr("0x1234"))一样。此函数可以返回字符串
stop,提前取消枚举。 -
onComplete():枚举完所有实例后调用。
-
-
ObjC.chooseSync(specifier):choose()的同步版本, 以数组形式返回实例。 -
ObjC.selector(name):将 JavaScript 字符串name转换为选择器。 -
ObjC.selectorAsString(sel):将选择器sel转换为 JavaScript 字符串。
Java
已迁移
从 Frida 17 开始,此运行时桥接不再内置于 Frida 的 GumJS 运行时中,
可通过运行以下命令获取:npm install frida-java-bridge。
按以下方式将其导入你的 agent:
import Java from 'frida-java-bridge';
目前,由 Frida REPL 和 frida-trace 加载的脚本不需要这样做。
-
Java.available:一个布尔值,指定当前进程是否已加载 Java VM,即 Dalvik 或 ART。 只有在值为真时,才能调用其他Java属性或方法。 -
Java.androidVersion:指定当前所运行 Android 版本的字符串。 -
ACC_PUBLIC,ACC_PRIVATE,ACC_PROTECTED,ACC_STATIC,ACC_FINAL,ACC_SYNCHRONIZED,ACC_BRIDGE,ACC_VARARGS,ACC_NATIVE,ACC_ABSTRACT,ACC_STRICT,ACC_SYNTHETIC:方法标志常量,每个常量都是数字,可用于Java.backtrace(). -
Java.enumerateLoadedClasses(callbacks):枚举当前已加载的类,其中callbacks是一个用于指定以下内容的对象:-
onMatch(name, handle):针对每个已加载的类调用;name可传给use()以获取 JavaScript 包装器。也可以通过Java.cast()将handle转换为java.lang.Class。 -
onComplete():枚举完所有类后调用。
-
-
Java.enumerateLoadedClassesSync():enumerateLoadedClasses()的同步版本, 以数组形式返回类名。 -
Java.enumerateClassLoaders(callbacks):枚举 Java VM 中存在的类加载器,其中callbacks是一个用于指定以下内容的对象:-
onMatch(loader):针对每个类加载器调用;loader是特定java.lang.ClassLoader的包装器。 -
onComplete():枚举完所有类加载器后调用。
可以将这样的加载器传给
Java.ClassFactory.get(),从而对指定类加载器中的类调用.use()。 -
-
Java.enumerateClassLoadersSync():enumerateClassLoaders()的同步版本, 以数组形式返回类加载器。 -
Java.enumerateMethods(query):枚举与query匹配的方法;查询以"class!method"格式指定,并允许使用 glob。末尾还可以附加/和一个或多个修饰符:-
i:不区分大小写匹配。 -
s:包含方法签名,例如"putInt"会变为"putInt(java.lang.String, int): void". -
u:仅匹配用户定义的类,忽略系统类。
-
Java.perform(() => {
  const groups = Java.enumerateMethods('*youtube*!on*')
  console.log(JSON.stringify(groups, null, 2));
});
[
{
"loader": "<instance: java.lang.ClassLoader, $className: dalvik.system.PathClassLoader>",
"classes": [
{
"name": "com.google.android.apps.youtube.app.watch.nextgenwatch.ui.NextGenWatchLayout",
"methods": [
"onAttachedToWindow",
"onDetachedFromWindow",
"onFinishInflate",
"onInterceptTouchEvent",
"onLayout",
"onMeasure",
"onSizeChanged",
"onTouchEvent",
"onViewRemoved"
]
},
{
"name": "com.google.android.apps.youtube.app.search.suggest.YouTubeSuggestionProvider",
"methods": [
"onCreate"
]
},
{
"name": "com.google.android.libraries.youtube.common.ui.YouTubeButton",
"methods": [
"onInitializeAccessibilityNodeInfo"
]
},
…
]
}
]-
Java.scheduleOnMainThread(fn):在 VM 主线程上运行fn。 -
Java.perform(fn):确保当前线程已附加到 VM,然后调用fn。(从 Java 发起的回调中 无需这样做。)如果应用的类加载器尚不可用,则延迟调用fn。如果不需要访问应用的类, 请使用Java.performNow()。
Java.perform(() => {
  const Activity = Java.use('android.app.Activity');
  Activity.onResume.implementation = function () {
    send('onResume() got called! Let\'s call the original implementation');
    this.onResume();
  };
});-
Java.performNow(fn):确保当前线程已附加到 VM,然后调用fn。 (从 Java 发起的回调中无需这样做。) -
Java.use(className):动态获取className的 JavaScript 包装器。可以对它调用$new()以调用构造函数并实例化对象。对实例调用$dispose()可显式清理它 (也可以等待 JavaScript 对象被垃圾回收,或等待脚本卸载)。静态和非静态方法均可用; 你甚至可以替换方法实现,并从中抛出异常:
Java.perform(() => {
  const Activity = Java.use('android.app.Activity');
  const Exception = Java.use('java.lang.Exception');
  Activity.onResume.implementation = function () {
    throw Exception.$new('Oh noes!');
  };
});
默认使用应用的类加载器,但可以通过向
Java.classFactory.loader分配其他加载器实例 进行自定义。请注意,所有方法包装器都提供
clone(options)API,用于创建带有自定义 NativeFunction 选项的新方法包装器。
-
Java.openClassFile(filePath):打开filePath处的 .dex 文件,返回一个具有以下方法的对象:-
load():将其中包含的类加载到 VM 中。 -
getClassNames():获取可用类名的数组。
-
-
Java.choose(className, callbacks):通过扫描 Java 堆枚举className类的活动实例, 其中callbacks是一个用于指定以下内容的对象:-
onMatch(instance):针对找到的每个活动实例调用,并提供可直接使用的instance, 就像使用此特定实例的原始句柄调用了Java.cast()一样。此函数可以返回字符串
stop,提前取消枚举。 -
onComplete():枚举完所有实例后调用。
-
-
Java.retain(obj):复制 JavaScript 包装器obj,以便之后在替换方法之外使用。
Java.perform(() => {
  const Activity = Java.use('android.app.Activity');
  let lastActivity = null;
  Activity.onResume.implementation = function () {
    lastActivity = Java.retain(this);
    this.onResume();
  };
});-
Java.cast(handle, klass):为handle处属于给定类klass的现有实例创建 JavaScript 包装器;后者由Java.use()返回。 此类包装器还具有class属性,用于获取其类的包装器;以及$className属性, 用于获取其类名的字符串表示形式。
const Activity = Java.use('android.app.Activity');
const activity = Java.cast(ptr('0x1234'), Activity);-
Java.array(type, elements):根据 JavaScript 数组elements创建一个元素为指定type的 Java 数组。生成的 Java 数组行为类似 JS 数组, 但可以按引用传给 Java API,使其能够修改数组内容。
const values = Java.array('int', [ 1003, 1005, 1007 ]);

const JString = Java.use('java.lang.String');
const str = JString.$new(Java.array('byte', [ 0x48, 0x65, 0x69 ]));-
Java.backtrace([options]):为当前线程生成回溯。可选的
options参数是一个对象,可以包含以下部分键:-
limit:要沿堆栈向上遍历的帧数,以数字表示。默认值为 16。
返回一个具有以下属性的对象:
-
id:可用于去重相同回溯的 ID,以字符串表示。 -
frames:堆栈帧。它是一个对象数组,其中的对象包含以下属性:-
signature:堆栈帧签名,以字符串表示,例如Landroid/os/Looper;,loopOnce,(Landroid/os/Looper;JI)Z -
origin:代码来源,即指定文件系统路径的字符串。在 Android 上,这是.dex的路径。 -
className:方法所属的类名,以字符串表示,例如android.os.Looper -
methodName:方法名,以字符串表示,例如loopOnce -
methodFlags:方法标志,以数字表示,例如Java.ACC_PUBLIC | Java.ACC_STATIC -
fileName:源文件名,以字符串表示,例如Looper.java -
lineNumber:源代码行号,以数字表示,例如201
-
-
-
Java.isMainThread():判断调用方是否正在主线程上运行。 -
Java.registerClass(spec):创建一个新的 Java 类并返回其包装器,其中spec是一个包含以下内容的对象:-
name:指定类名的字符串。 -
superClass:(可选)超类。省略时继承java.lang.Object. -
implements:(可选)此类实现的接口数组。 -
fields:(可选)指定要公开的每个字段的名称和类型的对象。 -
methods:(可选)指定要实现的方法的对象。
-
const SomeBaseClass = Java.use('com.example.SomeBaseClass');
const X509TrustManager = Java.use('javax.net.ssl.X509TrustManager');

const MyTrustManager = Java.registerClass({
  name: 'com.example.MyTrustManager',
  implements: [X509TrustManager],
  methods: {
    checkClientTrusted(chain, authType) {
    },
    checkServerTrusted(chain, authType) {
    },
    getAcceptedIssuers() {
      return [];
    },
  }
});

const MyWeirdTrustManager = Java.registerClass({
  name: 'com.example.MyWeirdTrustManager',
  superClass: SomeBaseClass,
  implements: [X509TrustManager],
  fields: {
    description: 'java.lang.String',
    limit: 'int',
  },
  methods: {
    $init() {
      console.log('Constructor called');
    },
    checkClientTrusted(chain, authType) {
      console.log('checkClientTrusted');
    },
    checkServerTrusted: [{
      returnType: 'void',
      argumentTypes: ['[Ljava.security.cert.X509Certificate;', 'java.lang.String'],
      implementation(chain, authType) {
        console.log('checkServerTrusted A');
      }
    }, {
      returnType: 'java.util.List',
      argumentTypes: ['[Ljava.security.cert.X509Certificate;', 'java.lang.String', 'java.lang.String'],
      implementation(chain, authType, host) {
        console.log('checkServerTrusted B');
        return null;
      }
    }],
    getAcceptedIssuers() {
      console.log('getAcceptedIssuers');
      return [];
    },
  }
});-
Java.deoptimizeEverything():强制 VM 使用解释器执行所有内容。在某些情况下, 这对于防止优化绕过方法 hook 是必要的,同时也允许使用 ART 的 Instrumentation API 跟踪运行时。 -
Java.deoptimizeBootImage():与 Java.deoptimizeEverything() 类似,但只对启动映像代码 进行去优化。配合dalvik.vm.dex2oat-flags --inline-max-code-units=0使用可获得最佳效果。 -
Java.vm:具有以下方法的对象:-
perform(fn):确保当前线程已附加到 VM,然后调用fn。(从 Java 发起的回调中 无需这样做。) -
getEnv():获取当前线程的JNIEnv包装器。如果当前线程未附加到 VM,则抛出异常。 -
tryGetEnv():尝试获取当前线程的JNIEnv包装器。如果当前线程未附加到 VM, 则返回null。
-
-
Java.classFactory:用于实现Java.use()等功能的默认类工厂。 使用应用的主类加载器。 -
Java.ClassFactory:具有以下属性的类:-
get(classLoader):获取给定类加载器的类工厂实例。内部使用的默认类工厂仅与应用的 主类加载器交互。可以通过Java.enumerateClassLoaders()发现其他类加载器, 并通过此 API 与其交互。 -
loader:只读属性,提供当前所用类加载器的包装器。对于默认类工厂,首次调用Java.perform()时会更新此属性。 -
cacheDir:包含当前所用缓存目录路径的字符串。对于默认类工厂,首次调用Java.perform()时会更新此属性。 -
tempFileNaming:指定临时文件命名约定的对象。默认值为{ prefix: 'frida', suffix: 'dat' }。 -
use(className):类似Java.use(),但用于特定类加载器。 -
openClassFile(filePath):类似Java.openClassFile(), 但用于特定类加载器。 -
choose(className, callbacks):类似Java.choose(), 但用于特定类加载器。 -
retain(obj):类似Java.retain(),但用于特定类加载器。 -
cast(handle, klass):类似Java.cast(),但用于特定类加载器。 -
array(type, elements):类似Java.array(),但用于特定类加载器。 -
registerClass(spec):类似Java.registerClass(), 但用于特定类加载器。
-
CPU 指令
Instruction
-
Instruction.parse(target):解析内存中target地址处的指令,该地址以NativePointer表示。请注意,在 32 位 ARM 上,ARM 函数地址的 最低有效位必须为 0,Thumb 函数则必须为 1。如果地址来自 Frida API(例如Module#getExportByName()),Frida 会替你处理这一细节。返回的对象包含以下字段:
-
address:此指令的地址(EIP),以NativePointer表示 -
next:指向下一条指令的指针,因此可以对其调用parse() -
size:此指令的大小 -
mnemonic:指令助记符的字符串表示 -
opStr:指令操作数的字符串表示 -
operands:描述各个操作数的对象数组;每个对象至少指定type和value, 也可能根据架构包含其他属性 -
regsAccessed:包含read和written属性的对象;两者分别是此指令 隐式或显式读取、写入的寄存器名称数组 -
regsRead:此指令隐式读取的寄存器名称数组 -
regsWritten:此指令隐式写入的寄存器名称数组 -
groups:此指令所属组的名称数组 -
toString():转换为人类可读的字符串
在 x86、ARM 和 AArch64 上,每个操作数还具有
access属性。它是字符串, 值为r、w、rw之一;不适用时为空字符串。ARM 和 AArch64 操作数还可能 指定shift、vectorIndex、subtracted(ARM)、ext和vas(AArch64)。有关
operands和groups的详细信息,请查阅适用于相应架构的 Capstone 文档。 -
ControlFlowGraph
-
new ControlFlowGraph(entrypoint):构建包含入口点entrypoint的函数的控制流图;该地址以NativePointer表示。函数边界的解析方式与Process.findFunctionRange()相同,并会自动确定其架构 和模式。在 32 位 ARM 上,最低有效位为 1 表示 Thumb。如果无法确定函数边界, 则抛出异常。 -
entrypoint:用于构建图的起始地址,以NativePointer表示 -
entryBlock:函数起始处的BasicBlock -
blocks:构成该图的所有BasicBlock对象的数组 -
findBlockContaining(address):返回BasicBlock,它包含address; 如果没有任何块覆盖该地址,则返回null -
dominates(a, b):返回一个布尔值,表示包含a的块是否支配包含b的块, 即从入口块到b的每条路径是否都经过a -
enumerateDominatingSites(target):枚举支配target的位置,按距离由近到远排列, 返回一个对象数组,其中包含:-
address:支配target且按指令对齐的地址,以NativePointer表示 -
capacity:address处可供重定向覆盖的连续字节数;这些字节位于单个范围内, 且没有入向分支,因此不会有其他控制流边落入被修补区域内部
当
target本身不适合挂钩时,这可用于寻找替代挂钩位置,例如与writeRedirect插桩选项结合使用。 -
基本块不能直接构造,只能通过图获得。每个 BasicBlock 都具有以下属性:
-
start:块中第一条指令的地址,以NativePointer表示 -
end:紧接块中最后一条指令之后的地址,以NativePointer表示 -
successors:控制流可从此块流向的块数组 -
predecessors:控制流可从中流入此块的块数组 -
immediateDominator:直接支配此块的块;对于入口块则为null -
instructions:构成此块的Instruction对象数组
例如:
const f = Module.getGlobalExportByName('open');
const cfg = new ControlFlowGraph(f);
for (const block of cfg.blocks) {
  console.log(`${block.start}-${block.end}:`,
      block.successors.map(b => b.start).join(', '));
}
X86Writer
-
new X86Writer(codeAddress[, { pc: ptr('0x1234') }]):新建一个代码写入器,用于生成 x86 机器码,并将其直接写入codeAddress指定的内存位置;该地址以 NativePointer 表示。 第二个参数是可选的选项对象,可在其中指定初始程序计数器;这在向临时 缓冲区生成代码时非常有用。尤其是在 iOS 上使用Memory.patchCode()时,该方法可能先提供一个临时位置, 随后再将其映射到预期的内存位置。 -
reset(codeAddress[, { pc: ptr('0x1234') }]):复用该实例 -
dispose():立即清理内存 -
flush():解析标签引用,并将待写入的数据写入内存。完成代码生成后应始终调用一次。 通常也建议在互不相关的代码片段之间调用,例如一次生成多个函数时。 -
base:输出首字节的内存位置,以 NativePointer 表示 -
code:输出下一字节的内存位置,以 NativePointer 表示 -
pc:输出下一字节处的程序计数器,以 NativePointer 表示 -
offset:当前偏移量,以 JavaScript Number 表示 -
putLabel(id):在当前位置放置标签,其中id是一个字符串, 可供此前或之后的put*Label()调用引用 -
putCallAddressWithArguments(func, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallAddressWithAlignedArguments(func, args):与上述方法相同,但还会确保参数列表按 16 字节边界对齐 -
putCallRegWithArguments(reg, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallRegWithAlignedArguments(reg, args):与上述方法相同,但还会确保参数列表按 16 字节边界对齐 -
putCallRegOffsetPtrWithArguments(reg, offset, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallAddress(address):写入一条 CALL 指令 -
putCallReg(reg):写入一条 CALL 指令 -
putCallRegOffsetPtr(reg, offset):写入一条 CALL 指令 -
putCallIndirect(addr):写入一条 CALL 指令 -
putCallIndirectLabel(labelId):写入一条 CALL 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putCallNearLabel(labelId):写入一条 CALL 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putLeave():写入一条 LEAVE 指令 -
putRet():写入一条 RET 指令 -
putRetImm(immValue):写入一条 RET 指令 -
putJmpAddress(address):写入一条 JMP 指令 -
putJmpShortLabel(labelId):写入一条 JMP 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putJmpNearLabel(labelId):写入一条 JMP 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putJmpReg(reg):写入一条 JMP 指令 -
putJmpRegPtr(reg):写入一条 JMP 指令 -
putJmpRegOffsetPtr(reg, offset):写入一条 JMP 指令 -
putJmpNearPtr(address):写入一条 JMP 指令 -
putJccShort(instructionId, target, hint):写入一条 JCC 指令 -
putJccNear(instructionId, target, hint):写入一条 JCC 指令 -
putJccShortLabel(instructionId, labelId, hint):写入一条 JCC 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putJccNearLabel(instructionId, labelId, hint):写入一条 JCC 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putAddRegImm(reg, immValue):写入一条 ADD 指令 -
putAddRegReg(dstReg, srcReg):写入一条 ADD 指令 -
putAddRegNearPtr(dstReg, srcAddress):写入一条 ADD 指令 -
putSubRegImm(reg, immValue):写入一条 SUB 指令 -
putSubRegReg(dstReg, srcReg):写入一条 SUB 指令 -
putSubRegNearPtr(dstReg, srcAddress):写入一条 SUB 指令 -
putIncReg(reg):写入一条 INC 指令 -
putDecReg(reg):写入一条 DEC 指令 -
putIncRegPtr(target, reg):写入一条 INC 指令 -
putDecRegPtr(target, reg):写入一条 DEC 指令 -
putLockXaddRegPtrReg(dstReg, srcReg):写入一条 LOCK XADD 指令 -
putLockCmpxchgRegPtrReg(dstReg, srcReg):写入一条 LOCK CMPXCHG 指令 -
putLockIncImm32Ptr(target):写入一条 LOCK INC IMM32 指令 -
putLockDecImm32Ptr(target):写入一条 LOCK DEC IMM32 指令 -
putAndRegReg(dstReg, srcReg):写入一条 AND 指令 -
putAndRegU32(reg, immValue):写入一条 AND 指令 -
putShlRegU8(reg, immValue):写入一条 SHL 指令 -
putShrRegU8(reg, immValue):写入一条 SHR 指令 -
putXorRegReg(dstReg, srcReg):写入一条 XOR 指令 -
putMovRegReg(dstReg, srcReg):写入一条 MOV 指令 -
putMovRegU32(dstReg, immValue):写入一条 MOV 指令 -
putMovRegU64(dstReg, immValue):写入一条 MOV 指令 -
putMovRegAddress(dstReg, address):写入一条 MOV 指令 -
putMovRegPtrU32(dstReg, immValue):写入一条 MOV 指令 -
putMovRegOffsetPtrU32(dstReg, dstOffset, immValue):写入一条 MOV 指令 -
putMovRegPtrReg(dstReg, srcReg):写入一条 MOV 指令 -
putMovRegOffsetPtrReg(dstReg, dstOffset, srcReg):写入一条 MOV 指令 -
putMovRegRegPtr(dstReg, srcReg):写入一条 MOV 指令 -
putMovRegRegOffsetPtr(dstReg, srcReg, srcOffset):写入一条 MOV 指令 -
putMovRegBaseIndexScaleOffsetPtr(dstReg, baseReg, indexReg, scale, offset):写入一条 MOV 指令 -
putMovRegNearPtr(dstReg, srcAddress):写入一条 MOV 指令 -
putMovNearPtrReg(dstAddress, srcReg):写入一条 MOV 指令 -
putMovFsU32PtrReg(fsOffset, srcReg):写入一条 MOV FS 指令 -
putMovRegFsU32Ptr(dstReg, fsOffset):写入一条 MOV FS 指令 -
putMovFsRegPtrReg(fsOffset, srcReg):写入一条 MOV FS 指令 -
putMovRegFsRegPtr(dstReg, fsOffset):写入一条 MOV FS 指令 -
putMovGsU32PtrReg(fsOffset, srcReg):写入一条 MOV GS 指令 -
putMovRegGsU32Ptr(dstReg, fsOffset):写入一条 MOV GS 指令 -
putMovGsRegPtrReg(gsOffset, srcReg):写入一条 MOV GS 指令 -
putMovRegGsRegPtr(dstReg, gsOffset):写入一条 MOV GS 指令 -
putMovqXmm0EspOffsetPtr(offset):写入一条 MOVQ XMM0 ESP 指令 -
putMovqEaxOffsetPtrXmm0(offset):写入一条 MOVQ EAX XMM0 指令 -
putMovdquXmm0EspOffsetPtr(offset):写入一条 MOVDQU XMM0 ESP 指令 -
putMovdquEaxOffsetPtrXmm0(offset):写入一条 MOVDQU EAX XMM0 指令 -
putLeaRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LEA 指令 -
putXchgRegRegPtr(leftReg, rightReg):写入一条 XCHG 指令 -
putPushU32(immValue):写入一条 PUSH 指令 -
putPushNearPtr(address):写入一条 PUSH 指令 -
putPushReg(reg):写入一条 PUSH 指令 -
putPopReg(reg):写入一条 POP 指令 -
putPushImmPtr(immPtr):写入一条 PUSH 指令 -
putPushax():写入一条 PUSHAX 指令 -
putPopax():写入一条 POPAX 指令 -
putPushfx():写入一条 PUSHFX 指令 -
putPopfx():写入一条 POPFX 指令 -
putSahf():写入一条 SAHF 指令 -
putLahf():写入一条 LAHF 指令 -
putTestRegReg(regA, regB):写入一条 TEST 指令 -
putTestRegU32(reg, immValue):写入一条 TEST 指令 -
putCmpRegI32(reg, immValue):写入一条 CMP 指令 -
putCmpRegOffsetPtrReg(regA, offset, regB):写入一条 CMP 指令 -
putCmpImmPtrImmU32(immPtr, immValue):写入一条 CMP 指令 -
putCmpRegReg(regA, regB):写入一条 CMP 指令 -
putClc():写入一条 CLC 指令 -
putStc():写入一条 STC 指令 -
putCld():写入一条 CLD 指令 -
putStd():写入一条 STD 指令 -
putCpuid():写入一条 CPUID 指令 -
putLfence():写入一条 LFENCE 指令 -
putRdtsc():写入一条 RDTSC 指令 -
putPause():写入一条 PAUSE 指令 -
putNop():写入一条 NOP 指令 -
putEndbr():写入一条 ENDBR 指令 -
putBreakpoint():写入一条特定于操作系统/架构的断点指令 -
putPadding(n):写入n条防护指令 -
putNopPadding(n):写入n条 NOP 指令 -
putFxsaveRegPtr(reg):写入一条 FXSAVE 指令 -
putFxrstorRegPtr(reg):写入一条 FXRSTOR 指令 -
putVmovdqu64RegOffsetPtrZmm(dstBase, dstOffset, srcZmm):写入一条 VMOVDQU64 ZMM 指令 -
putVmovdqu64ZmmRegOffsetPtr(dstZmm, srcBase, srcOffset):写入一条 VMOVDQU64 ZMM 指令 -
putVextracti64x4RegOffsetPtrZmm(dstBase, dstOffset, srcZmm, imm):写入一条 VEXTRACTI64X4 ZMM 指令 -
putVinserti64x4ZmmRegOffsetPtr(dstZmm, srcBase, srcOffset, imm):写入一条 VINSERTI64X4 ZMM 指令 -
putKmovqRegOffsetPtrKreg(dstBase, dstOffset, srcKreg):写入一条 KMOVQ KREG 指令 -
putKmovqKregRegOffsetPtr(dstKreg, srcBase, srcOffset):写入一条 KMOVQ KREG 指令 -
putU8(value):写入一个 uint8 -
putS8(value):写入一个 int8 -
putBytes(data):写入所提供 ArrayBuffer 中的原始数据
X86Relocator
-
new X86Relocator(inputCode, output):新建一个代码重定位器,用于将 x86 指令从一个内存位置复制到另一个位置, 并相应调整依赖位置的指令。源地址由inputCode指定,它是一个 NativePointer。目标地址由output给出,它是一个指向 预期目标内存地址的 X86Writer。 -
reset(inputCode, output):复用该实例 -
dispose():立即清理内存 -
input:目前为止读取到的最新 Instruction。初始值为null, 每次调用readOne()时都会更新。 -
eob:布尔值,表示是否已到达块末尾,即是否遇到了 CALL、JMP、BL、RET 等任意类型的分支 -
eoi:布尔值,表示是否已到达输入末尾,例如遇到 JMP/B/RET;这类指令之后可能有有效代码,也可能没有 -
readOne():将下一条指令读入重定位器的内部缓冲区,并返回截至目前读取的字节数, 其中包括此前调用读取的字节。可以继续调用此方法来持续缓冲,也可以立即调用writeOne()或skipOne()。还可以一直缓冲到所需位置, 然后调用writeAll()。到达输入末尾时返回零,此时eoi属性为true。 -
peekNextWriteInsn():查看下一条将被写入或跳过的 Instruction -
peekNextWriteSource():查看下一条将被写入或跳过的指令地址 -
skipOne():跳过原本将要写入的下一条指令 -
skipOneNoLabel():跳过原本将要写入的下一条指令,但不为内部使用创建标签。这样会破坏指向 已重定位范围内部位置的分支重定位;这是针对所有分支都会被重写的使用场景 (例如 Frida 的 Stalker)所做的优化。 -
writeOne():写入下一条已缓冲的指令 -
writeOneNoLabel():写入下一条已缓冲的指令,但不为内部使用创建标签。这样会破坏指向 已重定位范围内部位置的分支重定位;这是针对所有分支都会被重写的使用场景 (例如 Frida 的 Stalker)所做的优化。 -
writeAll():写入所有已缓冲的指令
x86 枚举类型
- 寄存器:
xaxxcxxdxxbxxspxbpxsixdieaxecxedxebxespebpesiediraxrcxrdxrbxrsprbprsirdir8r9r10r11r12r13r14r15r8dr9dr10dr11dr12dr13dr14dr15dxipeiprip - 指令 ID:
jojnojbjaejejnejbejajsjnsjpjnpjljgejlejgjcxzjecxzjrcxz - 分支提示:
no-hintlikelyunlikely - 指针目标:
bytedwordqword
ArmWriter
-
new ArmWriter(codeAddress[, { pc: ptr('0x1234') }]):新建一个代码写入器,用于生成 ARM 机器码,并将其直接写入codeAddress指定的内存位置;该地址以 NativePointer 表示。 第二个参数是可选的选项对象,可在其中指定初始程序计数器;这在向临时 缓冲区生成代码时非常有用。尤其是在 iOS 上使用Memory.patchCode()时,该方法可能先提供一个临时位置, 随后再将其映射到预期的内存位置。 -
reset(codeAddress[, { pc: ptr('0x1234') }]):复用该实例 -
dispose():立即清理内存 -
flush():解析标签引用,并将待写入的数据写入内存。完成代码生成后应始终调用一次。 通常也建议在互不相关的代码片段之间调用,例如一次生成多个函数时。 -
base:输出首字节的内存位置,以 NativePointer 表示 -
code:输出下一字节的内存位置,以 NativePointer 表示 -
pc:输出下一字节处的程序计数器,以 NativePointer 表示 -
offset:当前偏移量,以 JavaScript Number 表示 -
skip(nBytes):跳过nBytes字节 -
putLabel(id):在当前位置放置标签,其中id是一个字符串, 可供此前或之后的put*Label()调用引用 -
putCallAddressWithArguments(func, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallReg(reg):写入一条 CALL 指令 -
putCallRegWithArguments(reg, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putBranchAddress(address):写入分支或跳转到指定地址所需的代码 -
canBranchDirectlyBetween(from, to):判断给定的两个内存位置之间是否可以直接分支 -
putBImm(target):写入一条 B 指令 -
putBCondImm(cc, target):写入一条 B COND 指令 -
putBLabel(labelId):写入一条 B 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBCondLabel(cc, labelId):写入一条 B COND 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBlImm(target):写入一条 BL 指令 -
putBlxImm(target):写入一条 BLX 指令 -
putBlLabel(labelId):写入一条 BL 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBxReg(reg):写入一条 BX 指令 -
putBlReg(reg):写入一条 BL 指令 -
putBlxReg(reg):写入一条 BLX 指令 -
putRet():写入一条 RET 指令 -
putVpushRange(firstReg, lastReg):写入一条 VPUSH RANGE 指令 -
putVpopRange(firstReg, lastReg):写入一条 VPOP RANGE 指令 -
putLdrRegAddress(reg, address):写入一条 LDR 指令 -
putLdrRegU32(reg, val):写入一条 LDR 指令 -
putLdrRegReg(dstReg, srcReg):写入一条 LDR 指令 -
putLdrRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LDR 指令 -
putLdrCondRegRegOffset(cc, dstReg, srcReg, srcOffset):写入一条 LDR COND 指令 -
putLdmiaRegMask(reg, mask):写入一条 LDMIA MASK 指令 -
putLdmiaRegMaskWb(reg, mask):写入一条 LDMIA MASK WB 指令 -
putStrRegReg(srcReg, dstReg):写入一条 STR 指令 -
putStrRegRegOffset(srcReg, dstReg, dstOffset):写入一条 STR 指令 -
putStrCondRegRegOffset(cc, srcReg, dstReg, dstOffset):写入一条 STR COND 指令 -
putMovRegReg(dstReg, srcReg):写入一条 MOV 指令 -
putMovRegRegShift(dstReg, srcReg, shift, shiftValue):写入一条 MOV SHIFT 指令 -
putMovRegCpsr(reg):写入一条 MOV CPSR 指令 -
putMovCpsrReg(reg):写入一条 MOV CPSR 指令 -
putAddRegU16(dstReg, val):写入一条 ADD U16 指令 -
putAddRegU32(dstReg, val):写入一条 ADD 指令 -
putAddRegRegImm(dstReg, srcReg, immVal):写入一条 ADD 指令 -
putAddRegRegReg(dstReg, srcReg1, srcReg2):写入一条 ADD 指令 -
putAddRegRegRegShift(dstReg, srcReg1, srcReg2, shift, shiftValue):写入一条 ADD SHIFT 指令 -
putSubRegU16(dstReg, val):写入一条 SUB U16 指令 -
putSubRegU32(dstReg, val):写入一条 SUB 指令 -
putSubRegRegImm(dstReg, srcReg, immVal):写入一条 SUB 指令 -
putSubRegRegReg(dstReg, srcReg1, srcReg2):写入一条 SUB 指令 -
putRsbRegRegImm(dstReg, srcReg, immVal):写入一条 RSB 指令 -
putAndsRegRegImm(dstReg, srcReg, immVal):写入一条 ANDS 指令 -
putCmpRegImm(dstReg, immVal):写入一条 CMP 指令 -
putNop():写入一条 NOP 指令 -
putBreakpoint():写入一条特定于操作系统/架构的断点指令 -
putBrkImm(imm):写入一条 BRK 指令 -
putInstruction(insn):以 JavaScript Number 形式写入一条原始指令 -
putBytes(data):写入所提供 ArrayBuffer 中的原始数据
ArmRelocator
-
new ArmRelocator(inputCode, output):新建一个代码重定位器,用于将 ARM 指令从一个内存位置复制到另一个位置, 并相应调整依赖位置的指令。源地址由inputCode指定,它是一个 NativePointer。目标地址由output给出,它是一个指向 预期目标内存地址的 ArmWriter。 -
reset(inputCode, output):复用该实例 -
dispose():立即清理内存 -
input:目前为止读取到的最新 Instruction。初始值为null, 每次调用readOne()时都会更新。 -
eob:布尔值,表示是否已到达块末尾,即是否遇到了 CALL、JMP、BL、RET 等任意类型的分支 -
eoi:布尔值,表示是否已到达输入末尾,例如遇到 JMP/B/RET;这类指令之后可能有有效代码,也可能没有 -
readOne():将下一条指令读入重定位器的内部缓冲区,并返回截至目前读取的字节数, 其中包括此前调用读取的字节。可以继续调用此方法来持续缓冲,也可以立即调用writeOne()或skipOne()。还可以一直缓冲到所需位置, 然后调用writeAll()。到达输入末尾时返回零,此时eoi属性为true。 -
peekNextWriteInsn():查看下一条将被写入或跳过的 Instruction -
peekNextWriteSource():查看下一条将被写入或跳过的指令地址 -
skipOne():跳过原本将要写入的下一条指令 -
writeOne():写入下一条已缓冲的指令 -
writeAll():写入所有已缓冲的指令
ThumbWriter
-
new ThumbWriter(codeAddress[, { pc: ptr('0x1234') }]):新建一个代码写入器,用于生成 ARM 机器码,并将其直接写入codeAddress指定的内存位置;该地址以 NativePointer 表示。 第二个参数是可选的选项对象,可在其中指定初始程序计数器;这在向临时 缓冲区生成代码时非常有用。尤其是在 iOS 上使用Memory.patchCode()时,该方法可能先提供一个临时位置, 随后再将其映射到预期的内存位置。 -
reset(codeAddress[, { pc: ptr('0x1234') }]):复用该实例 -
dispose():立即清理内存 -
flush():解析标签引用,并将待写入的数据写入内存。完成代码生成后应始终调用一次。 通常也建议在互不相关的代码片段之间调用,例如一次生成多个函数时。 -
base:输出首字节的内存位置,以 NativePointer 表示 -
code:输出下一字节的内存位置,以 NativePointer 表示 -
pc:输出下一字节处的程序计数器,以 NativePointer 表示 -
offset:当前偏移量,以 JavaScript Number 表示 -
skip(nBytes):跳过nBytes字节 -
putLabel(id):在当前位置放置标签,其中id是一个字符串, 可供此前或之后的put*Label()调用引用 -
commitLabel(id):提交对指定标签的第一个待处理引用,成功时返回true。如果指定标签尚未定义, 或者已经没有对它的待处理引用,则返回false。 -
putCallAddressWithArguments(func, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallRegWithArguments(reg, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putBranchAddress(address):写入分支或跳转到指定地址所需的代码 -
canBranchDirectlyBetween(from, to):判断给定的两个内存位置之间是否可以直接分支 -
putBImm(target):写入一条 B 指令 -
putBLabel(labelId):写入一条 B 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBLabelWide(labelId):写入一条 B WIDE 指令 -
putBxReg(reg):写入一条 BX 指令 -
putBlImm(target):写入一条 BL 指令 -
putBlLabel(labelId):写入一条 BL 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBlxImm(target):写入一条 BLX 指令 -
putBlxReg(reg):写入一条 BLX 指令 -
putCmpRegImm(reg, immValue):写入一条 CMP 指令 -
putBeqLabel(labelId):写入一条 BEQ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBneLabel(labelId):写入一条 BNE 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBCondLabel(cc, labelId):写入一条 B COND 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBCondLabelWide(cc, labelId):写入一条 B COND WIDE 指令 -
putCbzRegLabel(reg, labelId):写入一条 CBZ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putCbnzRegLabel(reg, labelId):写入一条 CBNZ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putPushRegs(regs):使用指定寄存器写入一条 PUSH 指令。寄存器以 JavaScript 数组指定, 其中每个元素都是指定寄存器名称的字符串。 -
putPopRegs(regs):使用指定寄存器写入一条 POP 指令。寄存器以 JavaScript 数组指定, 其中每个元素都是指定寄存器名称的字符串。 -
putVpushRange(firstReg, lastReg):写入一条 VPUSH RANGE 指令 -
putVpopRange(firstReg, lastReg):写入一条 VPOP RANGE 指令 -
putLdrRegAddress(reg, address):写入一条 LDR 指令 -
putLdrRegU32(reg, val):写入一条 LDR 指令 -
putLdrRegReg(dstReg, srcReg):写入一条 LDR 指令 -
putLdrRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LDR 指令 -
putLdrbRegReg(dstReg, srcReg):写入一条 LDRB 指令 -
putVldrRegRegOffset(dstReg, srcReg, srcOffset):写入一条 VLDR 指令 -
putLdmiaRegMask(reg, mask):写入一条 LDMIA MASK 指令 -
putStrRegReg(srcReg, dstReg):写入一条 STR 指令 -
putStrRegRegOffset(srcReg, dstReg, dstOffset):写入一条 STR 指令 -
putMovRegReg(dstReg, srcReg):写入一条 MOV 指令 -
putMovRegU8(dstReg, immValue):写入一条 MOV 指令 -
putMovRegCpsr(reg):写入一条 MOV CPSR 指令 -
putMovCpsrReg(reg):写入一条 MOV CPSR 指令 -
putAddRegImm(dstReg, immValue):写入一条 ADD 指令 -
putAddRegReg(dstReg, srcReg):写入一条 ADD 指令 -
putAddRegRegReg(dstReg, leftReg, rightReg):写入一条 ADD 指令 -
putAddRegRegImm(dstReg, leftReg, rightValue):写入一条 ADD 指令 -
putSubRegImm(dstReg, immValue):写入一条 SUB 指令 -
putSubRegReg(dstReg, srcReg):写入一条 SUB 指令 -
putSubRegRegReg(dstReg, leftReg, rightReg):写入一条 SUB 指令 -
putSubRegRegImm(dstReg, leftReg, rightValue):写入一条 SUB 指令 -
putAndRegRegImm(dstReg, leftReg, rightValue):写入一条 AND 指令 -
putOrRegRegImm(dstReg, leftReg, rightValue):写入一条 OR 指令 -
putLslRegRegImm(dstReg, leftReg, rightValue):写入一条 LSL 指令 -
putLslsRegRegImm(dstReg, leftReg, rightValue):写入一条 LSLS 指令 -
putLsrsRegRegImm(dstReg, leftReg, rightValue):写入一条 LSRS 指令 -
putMrsRegReg(dstReg, srcReg):写入一条 MRS 指令 -
putMsrRegReg(dstReg, srcReg):写入一条 MSR 指令 -
putNop():写入一条 NOP 指令 -
putBkptImm(imm):写入一条 BKPT 指令 -
putBreakpoint():写入一条特定于操作系统/架构的断点指令 -
putInstruction(insn):以 JavaScript Number 形式写入一条原始指令 -
putInstructionWide(upper, lower):由两个 JavaScript Number 值写入一条原始 Thumb-2 指令 -
putBytes(data):写入所提供 ArrayBuffer 中的原始数据
ThumbRelocator
-
new ThumbRelocator(inputCode, output):新建一个代码重定位器,用于将 ARM 指令从一个内存位置复制到另一个位置, 并相应调整依赖位置的指令。源地址由inputCode指定,它是一个 NativePointer。目标地址由output给出,它是一个指向 预期目标内存地址的 ThumbWriter。 -
reset(inputCode, output):复用该实例 -
dispose():立即清理内存 -
input:目前为止读取到的最新 Instruction。初始值为null, 每次调用readOne()时都会更新。 -
eob:布尔值,表示是否已到达块末尾,即是否遇到了 CALL、JMP、BL、RET 等任意类型的分支 -
eoi:布尔值,表示是否已到达输入末尾,例如遇到 JMP/B/RET;这类指令之后可能有有效代码,也可能没有 -
readOne():将下一条指令读入重定位器的内部缓冲区,并返回截至目前读取的字节数, 其中包括此前调用读取的字节。可以继续调用此方法来持续缓冲,也可以立即调用writeOne()或skipOne()。还可以一直缓冲到所需位置, 然后调用writeAll()。到达输入末尾时返回零,此时eoi属性为true。 -
peekNextWriteInsn():查看下一条将被写入或跳过的 Instruction -
peekNextWriteSource():查看下一条将被写入或跳过的指令地址 -
skipOne():跳过原本将要写入的下一条指令 -
writeOne():写入下一条已缓冲的指令 -
copyOne():复制输出下一条已缓冲的指令,但不推进输出游标,从而可以多次写出同一条指令 -
writeAll():写入所有已缓冲的指令
ARM 枚举类型
- 寄存器:
r0r1r2r3r4r5r6r7r8r9r10r11r12r13r14r15splrsbslfpippcs0s1s2s3s4s5s6s7s8s9s10s11s12s13s14s15s16s17s18s19s20s21s22s23s24s25s26s27s28s29s30s31d0d1d2d3d4d5d6d7d8d9d10d11d12d13d14d15d16d17d18d19d20d21d22d23d24d25d26d27d28d29d30d31q0q1q2q3q4q5q6q7q8q9q10q11q12q13q14q15 - System寄存器:
apsr-nzcvq - 条件码:
eqnehslomiplvsvchilsgeltgtleal - Shifter:
asrlsllsrrorrrxasr-reglsl-reglsr-regror-regrrx-reg
Arm64Writer
-
new Arm64Writer(codeAddress[, { pc: ptr('0x1234') }]):新建一个代码写入器,用于生成 AArch64 机器码,并将其直接写入codeAddress指定的内存位置;该地址以 NativePointer 表示。 第二个参数是可选的选项对象,可在其中指定初始程序计数器;这在向临时 缓冲区生成代码时非常有用。尤其是在 iOS 上使用Memory.patchCode()时,该方法可能先提供一个临时位置, 随后再将其映射到预期的内存位置。 -
reset(codeAddress[, { pc: ptr('0x1234') }]):复用该实例 -
dispose():立即清理内存 -
flush():解析标签引用,并将待写入的数据写入内存。完成代码生成后应始终调用一次。 通常也建议在互不相关的代码片段之间调用,例如一次生成多个函数时。 -
base:输出首字节的内存位置,以 NativePointer 表示 -
code:输出下一字节的内存位置,以 NativePointer 表示 -
pc:输出下一字节处的程序计数器,以 NativePointer 表示 -
offset:当前偏移量,以 JavaScript Number 表示 -
skip(nBytes):跳过nBytes字节 -
putLabel(id):在当前位置放置标签,其中id是一个字符串, 可供此前或之后的put*Label()调用引用 -
putCallAddressWithArguments(func, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallRegWithArguments(reg, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putBranchAddress(address):写入分支或跳转到指定地址所需的代码 -
canBranchDirectlyBetween(from, to):判断给定的两个内存位置之间是否可以直接分支 -
putBImm(address):写入一条 B 指令 -
putBLabel(labelId):写入一条 B 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBCondLabel(cc, labelId):写入一条 B COND 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBlImm(address):写入一条 BL 指令 -
putBlLabel(labelId):写入一条 BL 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putBrReg(reg):写入一条 BR 指令 -
putBrRegNoAuth(reg):写入一条 BR 指令,要求提供不含任何认证位的原始指针 -
putJmpReg(reg):写入跳转到reg中地址所需的代码。发出 RET 而非 BR, 使受 BTI 保护的目标无需着陆垫。在不以这种方式保护页面的 arm64e 上会发出 BR。 -
putJmpRegNoAuth(reg):与putJmpReg()相同,但要求提供不含任何认证位的原始指针 -
putBlrReg(reg):写入一条 BLR 指令 -
putBlrRegNoAuth(reg):写入一条 BLR 指令,要求提供不含任何认证位的原始指针 -
putRet():写入一条 RET 指令 -
putRetReg(reg):写入一条 RET 指令 -
putCbzRegImm(reg, target):写入一条 CBZ 指令 -
putCbnzRegImm(reg, target):写入一条 CBNZ 指令 -
putCbzRegLabel(reg, labelId):写入一条 CBZ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putCbnzRegLabel(reg, labelId):写入一条 CBNZ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putTbzRegImmImm(reg, bit, target):写入一条 TBZ 指令 -
putTbnzRegImmImm(reg, bit, target):写入一条 TBNZ 指令 -
putTbzRegImmLabel(reg, bit, labelId):写入一条 TBZ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putTbnzRegImmLabel(reg, bit, labelId):写入一条 TBNZ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putPushRegReg(regA, regB):写入一条 PUSH 指令 -
putPopRegReg(regA, regB):写入一条 POP 指令 -
putPushAllXRegisters():写入将所有 X 寄存器压栈所需的代码 -
putPopAllXRegisters():写入从栈中弹出所有 X 寄存器所需的代码 -
putPushAllQRegisters():写入将所有 Q 寄存器压栈所需的代码 -
putPopAllQRegisters():写入从栈中弹出所有 Q 寄存器所需的代码 -
putLdrRegAddress(reg, address):写入一条 LDR 指令 -
putLdrRegU32(reg, val):写入一条 LDR 指令 -
putLdrRegU64(reg, val):写入一条 LDR 指令 -
putLdrRegU32Ptr(reg, srcAddress):写入一条 LDR 指令 -
putLdrRegU64Ptr(reg, srcAddress):写入一条 LDR 指令 -
putLdrRegRef(reg):写入一条带有悬空数据引用的 LDR 指令,并返回一个不透明的引用值; 应在所需位置将该值传给putLdrRegValue() -
putLdrRegValue(ref, value):写入该值,并更新先前由putLdrRegRef()写入的 LDR 指令 -
putLdrRegReg(dstReg, srcReg):写入一条 LDR 指令 -
putLdrRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LDR 指令 -
putLdrRegRegOffsetMode(dstReg, srcReg, srcOffset, mode):写入一条 LDR MODE 指令 -
putLdrswRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LDRSW 指令 -
putAdrpRegAddress(reg, address):写入一条 ADRP 指令 -
putStrRegReg(srcReg, dstReg):写入一条 STR 指令 -
putStrRegRegOffset(srcReg, dstReg, dstOffset):写入一条 STR 指令 -
putStrRegRegOffsetMode(srcReg, dstReg, dstOffset, mode):写入一条 STR MODE 指令 -
putLdpRegRegRegOffset(regA, regB, regSrc, srcOffset, mode):写入一条 LDP 指令 -
putStpRegRegRegOffset(regA, regB, regDst, dstOffset, mode):写入一条 STP 指令 -
putMovRegReg(dstReg, srcReg):写入一条 MOV 指令 -
putMovRegNzcv(reg):写入一条 MOV NZCV 指令 -
putMovNzcvReg(reg):写入一条 MOV NZCV 指令 -
putMovkRegImm(reg, imm, shift):写入一条 MOVK 指令 -
putUxtwRegReg(dstReg, srcReg):写入一条 UXTW 指令 -
putAddRegRegImm(dstReg, leftReg, rightValue):写入一条 ADD 指令 -
putAddRegRegReg(dstReg, leftReg, rightReg):写入一条 ADD 指令 -
putSubRegRegImm(dstReg, leftReg, rightValue):写入一条 SUB 指令 -
putSubRegRegReg(dstReg, leftReg, rightReg):写入一条 SUB 指令 -
putAndRegRegImm(dstReg, leftReg, rightValue):写入一条 AND 指令 -
putEorRegRegReg(dstReg, leftReg, rightReg):写入一条 EOR 指令 -
putUbfm(dstReg, srcReg, imms, immr):写入一条 UBFM 指令 -
putLslRegImm(dstReg, srcReg, shift):写入一条 LSL 指令 -
putLsrRegImm(dstReg, srcReg, shift):写入一条 LSR 指令 -
putTstRegImm(reg, immValue):写入一条 TST 指令 -
putCmpRegReg(regA, regB):写入一条 CMP 指令 -
putXpaciReg(reg):写入一条 XPACI 指令 -
putPaciaRegReg(dstReg, modReg):写入一条 PACIA 指令 -
putSvcImm(imm):写入一条 SVC 指令 -
putNop():写入一条 NOP 指令 -
putBti():写入一条 BTI 指令 -
putBrkImm(imm):写入一条 BRK 指令 -
putMrs(dstReg, systemReg):写入一条 MRS 指令 -
putInstruction(insn):以 JavaScript Number 形式写入一条原始指令 -
putBytes(data):写入所提供 ArrayBuffer 中的原始数据 -
sign(value):对给定的指针值进行签名
Arm64Relocator
-
new Arm64Relocator(inputCode, output):新建一个代码重定位器,用于将 AArch64 指令从一个内存位置复制到另一个位置, 并相应调整依赖位置的指令。源地址由inputCode指定,它是一个 NativePointer。目标地址由output给出,它是一个指向 预期目标内存地址的 Arm64Writer。 -
reset(inputCode, output):复用该实例 -
dispose():立即清理内存 -
input:目前为止读取到的最新 Instruction。初始值为null, 每次调用readOne()时都会更新。 -
eob:布尔值,表示是否已到达块末尾,即是否遇到了 CALL、JMP、BL、RET 等任意类型的分支 -
eoi:布尔值,表示是否已到达输入末尾,例如遇到 JMP/B/RET;这类指令之后可能有有效代码,也可能没有 -
readOne():将下一条指令读入重定位器的内部缓冲区,并返回截至目前读取的字节数, 其中包括此前调用读取的字节。可以继续调用此方法来持续缓冲,也可以立即调用writeOne()或skipOne()。还可以一直缓冲到所需位置, 然后调用writeAll()。到达输入末尾时返回零,此时eoi属性为true。 -
setScratchReg(reg):设置可供重定位代码出口使用的寄存器,前提是重定位后的指令尚未触及它 -
setCodeRange(range):设置寄存器活跃性分析可查看的代码范围。离开该范围的分支被视为会破坏 X16 和 X17。 -
readUntilResumable(scenario):继续读取,直到有暂存寄存器可用于跳回输入代码,或到达输入末尾。 如果两种情况都未发生,则返回false。 -
pickExitReg(target):选择一个分支到target的出口可使用的寄存器; 如果没有已知空闲的寄存器,则返回null -
peekNextWriteInsn():查看下一条将被写入或跳过的 Instruction -
peekNextWriteSource():查看下一条将被写入或跳过的指令地址 -
skipOne():跳过原本将要写入的下一条指令 -
writeOne():写入下一条已缓冲的指令 -
writeAll():写入所有已缓冲的指令
AArch64 枚举类型
- 寄存器:
x0x1x2x3x4x5x6x7x8x9x10x11x12x13x14x15x16x17x18x19x20x21x22x23x24x25x26x27x28x29x30w0w1w2w3w4w5w6w7w8w9w10w11w12w13w14w15w16w17w18w19w20w21w22w23w24w25w26w27w28w29w30splrfpwspwzrxzrnzcvip0ip1s0s1s2s3s4s5s6s7s8s9s10s11s12s13s14s15s16s17s18s19s20s21s22s23s24s25s26s27s28s29s30s31d0d1d2d3d4d5d6d7d8d9d10d11d12d13d14d15d16d17d18d19d20d21d22d23d24d25d26d27d28d29d30d31q0q1q2q3q4q5q6q7q8q9q10q11q12q13q14q15q16q17q18q19q20q21q22q23q24q25q26q27q28q29q30q31 - 条件码:
eqnehslomiplvsvchilsgeltgtlealnv - 索引模式:
post-adjustsigned-offsetpre-adjust - Scenario:
offlineonline
MipsWriter
-
new MipsWriter(codeAddress[, { pc: ptr('0x1234') }]):新建一个代码写入器,用于生成 MIPS 机器码,并将其直接写入codeAddress指定的内存位置;该地址以 NativePointer 表示。 第二个参数是可选的选项对象,可在其中指定初始程序计数器;这在向临时 缓冲区生成代码时非常有用。尤其是在 iOS 上使用Memory.patchCode()时,该方法可能先提供一个临时位置, 随后再将其映射到预期的内存位置。 -
reset(codeAddress[, { pc: ptr('0x1234') }]):复用该实例 -
dispose():立即清理内存 -
flush():解析标签引用,并将待写入的数据写入内存。完成代码生成后应始终调用一次。 通常也建议在互不相关的代码片段之间调用,例如一次生成多个函数时。 -
base:输出首字节的内存位置,以 NativePointer 表示 -
code:输出下一字节的内存位置,以 NativePointer 表示 -
pc:输出下一字节处的程序计数器,以 NativePointer 表示 -
offset:当前偏移量,以 JavaScript Number 表示 -
skip(nBytes):跳过nBytes字节 -
putLabel(id):在当前位置放置标签,其中id是一个字符串, 可供此前或之后的put*Label()调用引用 -
putCallAddressWithArguments(func, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putCallRegWithArguments(reg, args):写入调用 C 函数所需的代码,并使用指定的args。该参数是 JavaScript 数组, 每个元素可以是指定寄存器的字符串,也可以是指定立即数值的 Number 或 NativePointer。 -
putJAddress(address):写入一条 J 指令 -
putJAddressWithoutNop(address):写入一条 J WITHOUT NOP 指令 -
putJLabel(labelId):写入一条 J 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putJrReg(reg):写入一条 JR 指令 -
putJalAddress(address):写入一条 JAL 指令 -
putJalrReg(reg):写入一条 JALR 指令 -
putBOffset(offset):写入一条 B 指令 -
putBeqRegRegLabel(rightReg, leftReg, labelId):写入一条 BEQ 指令 引用labelId;该标签可由此前或之后的putLabel()定义 -
putRet():写入一条 RET 指令 -
putLaRegAddress(reg, address):写入一条 LA 指令 -
putLuiRegImm(reg, imm):写入一条 LUI 指令 -
putDsllRegReg(dstReg, srcReg, amount):写入一条 DSLL 指令 -
putOriRegRegImm(rt, rs, imm):写入一条 ORI 指令 -
putLdRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LD 指令 -
putLwRegRegOffset(dstReg, srcReg, srcOffset):写入一条 LW 指令 -
putSwRegRegOffset(srcReg, dstReg, dstOffset):写入一条 SW 指令 -
putMoveRegReg(dstReg, srcReg):写入一条 MOVE 指令 -
putAdduRegRegReg(dstReg, leftReg, rightReg):写入一条 ADDU 指令 -
putAddiRegRegImm(dstReg, leftReg, imm):写入一条 ADDI 指令 -
putAddiRegImm(dstReg, imm):写入一条 ADDI 指令 -
putSubRegRegImm(dstReg, leftReg, imm):写入一条 SUB 指令 -
putPushReg(reg):写入一条 PUSH 指令 -
putPopReg(reg):写入一条 POP 指令 -
putMfhiReg(reg):写入一条 MFHI 指令 -
putMfloReg(reg):写入一条 MFLO 指令 -
putMthiReg(reg):写入一条 MTHI 指令 -
putMtloReg(reg):写入一条 MTLO 指令 -
putNop():写入一条 NOP 指令 -
putBreak():写入一条 BREAK 指令 -
putPrologueTrampoline(reg, address):写入一个尺寸最小的跳板,用于转向指定地址 -
putInstruction(insn):以 JavaScript Number 形式写入一条原始指令 -
putBytes(data):写入所提供 ArrayBuffer 中的原始数据
MipsRelocator
-
new MipsRelocator(inputCode, output):新建一个代码重定位器,用于将 MIPS 指令从一个内存位置复制到另一个位置, 并相应调整依赖位置的指令。源地址由inputCode指定,它是一个 NativePointer。目标地址由output给出,它是一个指向 预期目标内存地址的 MipsWriter。 -
reset(inputCode, output):复用该实例 -
dispose():立即清理内存 -
input:目前为止读取到的最新 Instruction。初始值为null, 每次调用readOne()时都会更新。 -
eob:布尔值,表示是否已到达块末尾,即是否遇到了 CALL、JMP、BL、RET 等任意类型的分支 -
eoi:布尔值,表示是否已到达输入末尾,例如遇到 JMP/B/RET;这类指令之后可能有有效代码,也可能没有 -
readOne():将下一条指令读入重定位器的内部缓冲区,并返回截至目前读取的字节数, 其中包括此前调用读取的字节。可以继续调用此方法来持续缓冲,也可以立即调用writeOne()或skipOne()。还可以一直缓冲到所需位置, 然后调用writeAll()。到达输入末尾时返回零,此时eoi属性为true。 -
peekNextWriteInsn():查看下一条将被写入或跳过的 Instruction -
peekNextWriteSource():查看下一条将被写入或跳过的指令地址 -
skipOne():跳过原本将要写入的下一条指令 -
writeOne():写入下一条已缓冲的指令 -
writeAll():写入所有已缓冲的指令
MIPS 枚举类型
- 寄存器:
v0v1a0a1a2a3t0t1t2t3t4t5t6t7s0s1s2s3s4s5s6s7t8t9k0k1gpspfps8rahilozeroat012345678910111213141516171819202122232425262728293031
其他
Console
-
console.log(line),console.warn(line),console.error(line): 将line写入基于 Frida 的应用程序控制台。具体行为取决于 frida-core 集成在何处。 例如,通过 frida-python 使用 Frida 时, 输出会写入 stdout 或 stderr;通过 qDebug 输出时则使用 frida-qml,以此类推。如果参数是 ArrayBuffer 对象,则会替换为使用默认选项调用
hexdump()的结果。
Hexdump
-
hexdump(target[, options]):从给定的 ArrayBuffer 或 NativePointertarget生成十六进制转储;可通过可选的options自定义输出。例如:
const libc = Process.getModuleByName('libc.so').base;
console.log(hexdump(libc, {
  /* address: ptr('0x1000'), -- to override the base address */
  offset: 0,
  length: 64,
  header: true,
  ansi: true
}));
0 1 2 3 4 5 6 7 8 9 A B C D E F 0123456789ABCDEF
00000000 7f 45 4c 46 01 01 01 00 00 00 00 00 00 00 00 00 .ELF............
00000010 03 00 28 00 01 00 00 00 00 00 00 00 34 00 00 00 ..(.........4...
00000020 34 a8 04 00 00 00 00 05 34 00 20 00 08 00 28 00 4.......4. ...(.
00000030 1e 00 1d 00 06 00 00 00 34 00 00 00 34 00 00 00 ........4...4...Checksum
-
Checksum.compute(type, data):计算data的校验和;该数据可以是字符串、 ArrayBuffer,也可以是字节值数组。type是字符串,可指定为md5、sha1、sha256、sha384或sha512。返回全小写十六进制字符串形式的 校验和。 -
new Checksum(type):创建一个实例,用于计算数据流的type类型校验和。实例初始处于“打开”状态, 可通过一次或多次调用update()输入数据。完成后,调用getString()或getDigest()获取计算出的校验和。这也会使实例进入“关闭”状态,此后不能再调用update()。 -
update(data):将data输入校验和,其中data的类型与Checksum.compute()接受的类型相同。返回校验和实例,以便链式调用。 -
getString():关闭校验和并以全小写十六进制字符串返回摘要。 -
getDigest():关闭校验和并以 ArrayBuffer 返回摘要。 -
peekString(),peekDigest():与getString()和getDigest()相同,但不会关闭校验和, 因此之后仍可继续更新。 -
copy():创建校验和实例的副本。副本与原实例处于相同状态,因此已关闭的 校验和复制后仍为关闭状态。
console.log(Checksum.compute('sha256', 'Hello'));

const checksum = new Checksum('md5');
checksum.update('ab').update('c');
console.log(checksum.getString());
简写
-
int64(v):是以下写法的简写:new Int64(v) -
uint64(v):是以下写法的简写:new UInt64(v) -
ptr(s):是以下写法的简写:new NativePointer(s) -
NULL:是以下写法的简写:ptr("0")
宿主与注入进程之间的通信
-
recv([type, ]callback):请求在下一次收到来自基于 Frida 的应用程序的消息时调用callback。 可以指定可选的type,从而只接收type字段设为type的消息。消息通过第一个参数传入;如果消息附带二进制数据,第二个参数会是 ArrayBuffer,否则为 null。
此调用只会提供一条消息,因此需要再次调用
recv()才能接收下一条消息。 -
send(message[, data]):将 JavaScript 对象message发送到基于 Frida 的应用程序(它必须能序列化为 JSON)。 如果还想随消息发送一些原始二进制数据,例如使用NativePointer#readByteArray转储的内存, 可以通过可选的data参数传入。它必须是 ArrayBuffer, 或由 0 到 255 之间的整数组成的数组。性能注意事项
虽然 send() 是异步的,但发送单条消息的总开销并未针对高频率进行优化。 因此,Frida 将如何把多个值批量放入一次 send() 调用交由你决定, 具体取决于你需要低延迟还是高吞吐量。
-
rpc.exports:一个空对象,可以替换它或向其中插入成员,从而向应用程序 暴露 RPC 风格的 API。键指定方法名称,值是导出的函数。该函数既可以返回普通值, 以便立即返回给调用方,也可以返回 Promise 以异步返回。
例如:
rpc.exports = {
  add(a, b) {
    return a + b;
  },
  sub(a, b) {
    return new Promise(resolve => {
      setTimeout(() => {
        resolve(a - b);
      }, 100);
    });
  }
};
在使用 Node.js 绑定的应用程序中,可以像下面这样调用此 API:
const frida = require('frida');
const fs = require('fs');
const path = require('path');
const util = require('util');

const readFile = util.promisify(fs.readFile);

let session, script;
async function run() {
  const source = await readFile(path.join(__dirname, '_agent.js'), 'utf8');
  session = await frida.attach('iTunes');
  script = await session.createScript(source);
  script.message.connect(onMessage);
  await script.load();
  console.log(await script.exports.add(2, 3));
  console.log(await script.exports.sub(5, 3));
}

run().catch(onError);

function onError(error) {
  console.error(error.stack);
}

function onMessage(message, data) {
  if (message.type === 'send') {
    console.log(message.payload);
  } else if (message.type === 'error') {
    console.error(message.stack);
  }
}
Python 版本与此非常相似:
import codecs
import frida

def on_message(message, data):
    if message['type'] == 'send':
        print(message['payload'])
    elif message['type'] == 'error':
        print(message['stack'])

session = frida.attach('iTunes')
with codecs.open('./agent.js', 'r', 'utf-8') as f:
    source = f.read()
script = session.create_script(source)
script.on('message', on_message)
script.load()
print(script.exports.add(2, 3))
print(script.exports.sub(5, 3))
session.detach()
在上面的示例中,我们使用 script.on('message', on_message) 监控来自注入进程
JavaScript 端的所有消息。script 和 session 上还有其他可监听的通知。
如果希望在目标进程退出时收到通知,请使用
session.on('detached', your_function)。
定时事件
-
setTimeout(func, delay[, ...parameters]):调用func,延迟时间为delay毫秒,并可选择向其传入一个或多个parameters。 返回一个 ID,可将其传给clearTimeout以取消调用。 -
clearTimeout(id):取消调用setTimeout返回的 ID。 -
setInterval(func, delay[, ...parameters]):重复调用func,间隔时间为delay毫秒,并可选择向其传入一个或多个parameters。 返回一个 ID,可将其传给clearInterval以取消调用。 -
clearInterval(id):取消调用setInterval返回的 ID。 -
setImmediate(func[, ...parameters]):安排尽快在 Frida 的 JavaScript 线程上调用func,并可选择向其传入一个或多个parameters。返回一个 ID,可将其传给clearImmediate以取消调用。 -
clearImmediate(id):取消调用setImmediate返回的 ID。
垃圾回收
-
gc():强制执行垃圾回收。适用于测试,尤其是涉及Script.bindWeak()的逻辑。
Worker
Worker 脚本拥有自己的 JavaScript 堆、锁等。
这适合将繁重处理移到后台线程,让 hook 能得到及时处理。
-
new Worker(url[, options]):创建一个新的 worker,并执行指定url处的脚本。通常可让模块导出自身的
import.meta.url,再由创建 worker 的模块导入它, 以此取得该 URL。如果指定了
options,它是一个可包含下列一个或多个键的对象: -
terminate():终止 worker。 -
post(message[, data]):向 worker 发送消息。签名与 send() 相同。 在 worker 内部使用 recv() 接收消息。 -
exports:一个魔法代理对象,用于调用 worker 定义的 rpc.exports。每个函数都返回一个 Promise,可以在 async 函数中对其使用 await。
Cloak
在进程自省期间避免看到自身。
诸如 Process.enumerateThreads() 之类的自省 API
会确保跳过已隐藏的资源,使一切看起来就像你并未位于正在插桩的进程中。
Frida 运行时创建的所有资源都会自动隐藏。这意味着通常只有在使用特定于操作系统的 API 创建某项资源时,才需要管理隐藏资源。
-
Cloak.addThread(id):更新隐藏资源注册表,使指定线程id对支持隐藏的 API 不可见, 例如Process.enumerateThreads()。 -
Cloak.removeThread(id):更新隐藏资源注册表,使指定线程id对支持隐藏的 API 可见, 例如Process.enumerateThreads()。 -
Cloak.hasCurrentThread():返回布尔值,表示当前线程目前是否已隐藏。 -
Cloak.hasThread(id):返回布尔值,表示指定线程id目前是否已隐藏。 -
Cloak.addRange(range):更新隐藏资源注册表,使指定内存range对支持隐藏的 API 不可见, 例如Process.enumerateRanges()。所提供的range是 带有base和size属性的对象,类似于Process.getModuleByName()等方法返回的对象。 -
Cloak.removeRange(range):更新隐藏资源注册表,使指定内存range对支持隐藏的 API 可见, 例如Process.enumerateRanges()。所提供的range是 带有base和size属性的对象,类似于Process.getModuleByName()等方法返回的对象。 -
Cloak.hasRangeContaining(address):返回布尔值,表示包含指定地址的内存范围目前是否已隐藏; 该address以 NativePointer 指定。 -
Cloak.clipRange(range):确定给定内存range中当前有多少可见。所提供的range是带有base和size属性的对象,类似于Process.getModuleByName()等方法返回的对象。返回由此类对象组成的数组,表示range的可见部分。 如果整个范围都已隐藏,则返回空数组;如果完全可见,则返回null。 -
Cloak.addFileDescriptor(fd):更新隐藏资源注册表,使指定文件描述符fd对支持隐藏的 API 不可见。 -
Cloak.removeFileDescriptor(fd):更新隐藏资源注册表,使指定文件描述符fd对支持隐藏的 API 可见。 -
Cloak.hasFileDescriptor(fd):返回布尔值,表示指定文件描述符fd目前是否已隐藏。
Profiler
基于 Interceptor 构建的简单最坏情况性能分析器。
传统性能分析器按一定频率对调用栈采样,而在这里,你可以准确决定要分析哪些函数。
当这些函数中的任意一个被调用时,分析器会在进入时采集一个样本,并在返回时再采集一个。 随后用两者相减,计算这次调用的开销。如果结果大于此前为该函数观测到的值, 该结果就会成为新的最坏情况。
发现新的最坏情况时,只知道大部分时间、周期等花在某个特定函数上并不一定足够。 例如,该函数可能只在某些输入参数下才会变慢。
在这种情况下,可以为特定函数传入 describe 回调。
回调应从参数列表和/或其他状态中捕获相关上下文,并返回一个字符串,
用于描述刚发现的新最坏情况。
之后调用 generateReport() 时,可以看到计算出的描述嵌入在各个最坏情况条目中。
-
new Profiler():创建一个 Profiler。 -
instrument(functionAddress, sampler[, callbacks]):开始对指定函数进行插桩;该函数由functionAddressNativePointer指定,并使用sampler。可选的
callbacks参数是一个对象,可包含:-
describe(args):发现新的最坏情况时同步调用,此时应从参数列表和/或其他相关状态中 捕获描述。实现必须返回一个描述参数列表的字符串。有关args以及this绑定方式的更多信息,请参阅 Interceptor 的onEnter。
-
-
generateReport():根据实时分析器状态生成 XML 报告,并以字符串返回。 可在任意时刻调用,且调用次数不限。
Sampler
-
sample():获取一个新样本,以 bigint 返回。其含义取决于具体采样器。
CycleSampler
测量 CPU 周期的采样器,例如在 x86 上使用 RDTSC 指令。
-
new CycleSampler():创建一个 CycleSampler。
BusyCycleSampler
仅测量当前线程消耗的 CPU 周期的采样器,例如在 Windows 上使用 QueryThreadCycleTime()。
-
new BusyCycleSampler():创建一个 BusyCycleSampler。
WallClockSampler
测量经过时间的采样器。
-
new WallClockSampler():创建一个 WallClockSampler。
UserTimeSampler
测量用户空间耗时的采样器。
-
new UserTimeSampler([threadId]):创建一个 UserTimeSampler,对数字threadId指定的线程采样; 如果省略,则对当前线程采样。
MallocCountSampler
统计 malloc()、calloc() 和 realloc() 调用次数的采样器。
-
new MallocCountSampler():创建一个 MallocCountSampler。
CallCountSampler
统计所选函数调用次数的采样器。
-
new CallCountSampler(functions):创建一个 CallCountSampler,对functions的调用次数采样。该参数是NativePointer值数组,用于指定要统计调用次数的函数。